들어가며
지금까지 이 시리즈에서는 두 개 이상의 테이블을 조인하는 방법(1~2편)과 단일 테이블에서 인덱스를 더 잘 활용하는 방법(3편)을 다뤘습니다.
https://dmoritle.tistory.com/268
[MySQL] 고급 최적화 (3) - 단일 테이블에서 인덱스를 더 잘 쓰는 법: ICP, 인덱스 확장, 인덱스 머지,
들어가며[1편: BNL, MRR & BKA]와 [2편: Hash Join]에서는 두 개 이상의 테이블을 연결할 때 MySQL이 어떤 알고리즘으로 조인을 실행하는지를 다뤘습니다.https://dmoritle.tistory.com/266 [MySQL] 고급 최적화 (1) -
dmoritle.tistory.com
이번 편에서 다룰 주제는 그 둘의 성격을 조금씩 가지고 있습니다. WHERE ... IN (SELECT ...)나 WHERE EXISTS (SELECT ...) 같은 서브쿼리는, 결국 내부적으로는 조인과 비슷한 방식으로 처리됩니다. 하지만 일반적인 조인과는 다른 제약이 하나 있고, MySQL 옵티마이저는 이 제약을 다섯 가지 방법(Table Pullout, Duplicate Weedout, FirstMatch, LooseScan, Materialization) 중 하나로 처리합니다. 이 다섯 가지를 순서대로 살펴보겠습니다.
세미조인이란 무엇인가
일반 조인과의 차이
수강 과목(class)과 수강생 명단(roster) 두 테이블이 있다고 하겠습니다.
CREATE TABLE class (
  class_num INT PRIMARY KEY,
  class_name VARCHAR(50)
);

CREATE TABLE roster (
  student_id INT,
  class_num INT,
  INDEX idx_class_num (class_num)
);
"실제로 수강생이 있는 과목 목록"을 뽑고 싶다면, 일반적인 조인으로는 이렇게 쓸 수 있습니다.
SELECT class.class_num, class.class_name
FROM class INNER JOIN roster
WHERE class.class_num = roster.class_num;
문제는 이 결과가 과목당 한 번이 아니라, 그 과목을 듣는 학생 수만큼 중복되어 나온다는 점입니다. 과목 하나에 학생이 30명이면 그 과목이 30번 나옵니다. 우리가 알고 싶은 건 "그 과목에 수강생이 있는가 없는가"뿐인데, 조인은 "몇 명이 듣는가"까지 알려주는 셈입니다.
이걸 중복 없이 구하려면 보통 IN이나 EXISTS 서브쿼리를 씁니다.
SELECT class_num, class_name
FROM class
WHERE class_num IN (SELECT class_num FROM roster);
세미조인이라는 이름
이렇게 "매칭되는 로우가 몇 개든 상관없이, 매칭 여부만 필요한" 조인 형태를 세미조인(semijoin)이라고 부릅니다. class가 아우터 테이블, roster가 서브쿼리 안의 이너 테이블입니다.
MySQL 옵티마이저는 이런 IN/EXISTS 서브쿼리를 준비 단계에서 세미조인으로 변환합니다. 그런데 변환한다고 해서 무작정 INNER JOIN처럼 실행할 수는 없습니다. 그러면 위에서 본 것처럼 중복이 생기니까요. 그래서 옵티마이저는 중복을 어떻게 처리할 것인가에 따라 서로 다른 다섯 가지 실행 전략 중 하나를 선택합니다.
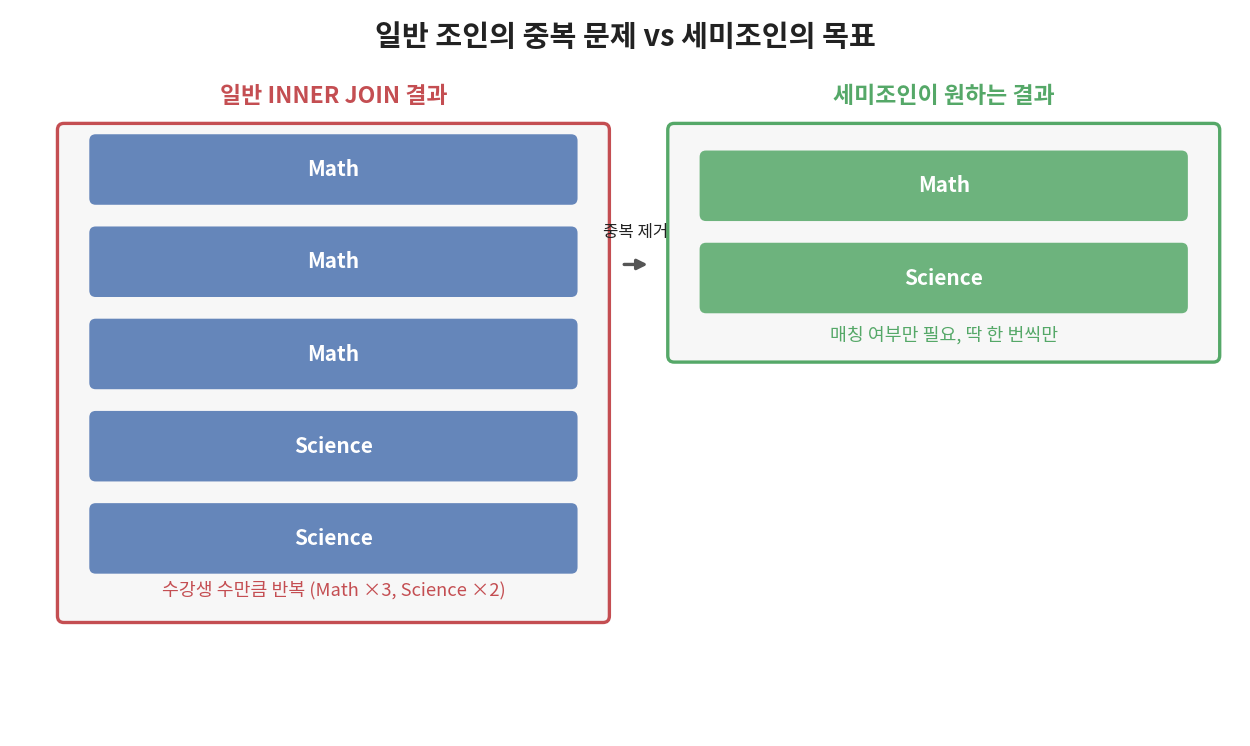
Table Pullout
중복이 원천적으로 불가능하다면
네 가지 전략을 보기 전에, 가장 특별한 경우를 하나 짚어야 합니다. 애초에 중복이 생길 수 없는 상황이라면 어떨까요?
CREATE TABLE country (
  code CHAR(3) PRIMARY KEY,
  population INT
);

CREATE TABLE city (
  name VARCHAR(50),
  country_code CHAR(3)
);

SELECT * FROM city
WHERE country_code IN (
  SELECT code FROM country WHERE population < 100000
);country.code는 PK입니다. 즉 code 값 하나당 country 로우는 정확히 하나만 존재할 수 있습니다. 이 경우 서브쿼리가 만들어내는 값 목록에는 애초에 중복이 있을 수 없고, city 쪽에서 봐도 매칭되는 country 로우가 여러 개일 가능성이 없습니다.
이럴 때는 아예 중복 제거 로직 자체가 필요 없습니다. MySQL은 이 사실을 인지하고, country 테이블을 서브쿼리에서 통째로 끌어내어(pull out) 바깥쪽 쿼리의 평범한 조인 대상으로 만들어버립니다. 사실상 다음 쿼리와 동일하게 처리하는 것입니다.
SELECT city.* FROM city
JOIN country ON city.country_code = country.code
WHERE country.population < 100000;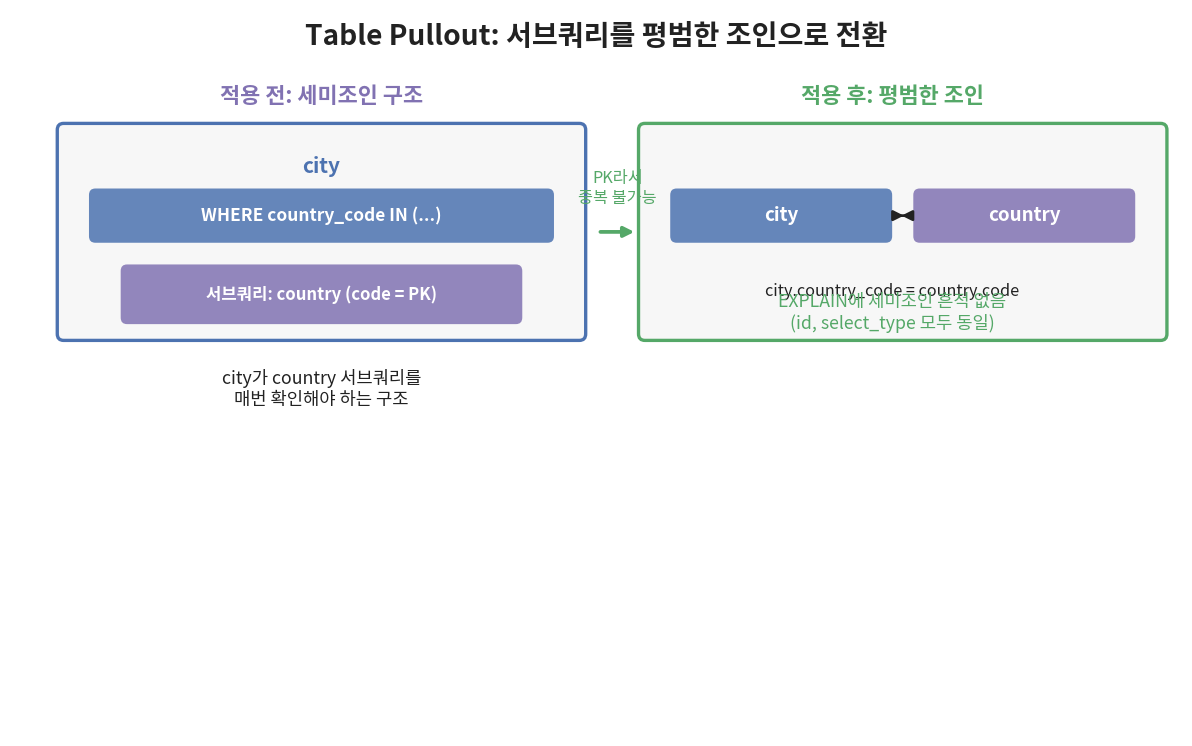
확인 방법
Table Pullout이 적용되면 EXPLAIN에는 세미조인의 흔적이 전혀 남지 않습니다. country와 city가 그냥 같은 id, 같은 select_type(PRIMARY)을 가진 두 줄로 나란히 나와서, 원래부터 평범한 조인이었던 것처럼 보입니다. 서브쿼리 테이블 안의 조인 조건 컬럼이 PK나 유니크 인덱스일 때만 성립하며, 별도의 optimizer_switch 플래그는 없습니다. 전체 semijoin 플래그를 끄면 Table Pullout도 함께 꺼집니다.
서브쿼리 안의 테이블이 여러 개라면 그중 조건을 만족하는 테이블만 부분적으로 끌어낼 수도 있고, 전부 끌어낼 수 있다면 세미조인이라는 개념 자체가 사라지고 완전히 평범한 조인이 됩니다.
Duplicate Weedout
일단 조인하고, 나중에 걸러낸다
Table Pullout으로 처리할 수 없는 경우, 즉 서브쿼리 테이블의 조인 조건 컬럼이 PK나 유니크 인덱스가 아니라서 중복 가능성이 실제로 있는 경우부터가 진짜 "세미조인 실행 전략"이 필요한 지점입니다. 가장 직관적인 방법은 "일반 조인처럼 그냥 실행하고, 중복된 결과를 나중에 걸러내는" 것입니다. 이게 Duplicate Weedout입니다.
SELECT class_num, class_name
FROM class
WHERE class_num IN (SELECT class_num FROM roster);
Duplicate Weedout은 class와 roster를 일반 조인처럼 실행하면서, 그 과정에서 나온 class쪽 로우의 PK를 임시 테이블에 기록합니다. 이 임시 테이블에는 PK에 유니크 인덱스가 걸려 있어서, 이미 나온 적 있는 PK가 다시 나오면 그 로우는 버립니다. 조인은 끝까지 일반 조인처럼 진행되지만, 최종 결과에는 중복이 남지 않는 구조입니다.
EXPLAIN에서는 Extra 컬럼에 Start temporary와 End temporary로 표시됩니다. 이 두 표시 사이에 있는 테이블들이 중복 제거 대상 범위입니다.
장점과 특징
Duplicate Weedout은 조인 순서에 별다른 제약을 걸지 않습니다. 아우터 테이블과 이너 테이블을 어떤 순서로 조인하든 상관없이 적용할 수 있어서, 다른 전략들이 적용되지 않는 상황에서도 대체로 쓸 수 있는 범용적인 방법입니다. 그래서 옵티마이저 스위치에서 다른 세미조인 전략을 전부 꺼도, 적용 가능한 전략이 하나도 안 남으면 결국 Duplicate Weedout이 선택됩니다.
FirstMatch
매칭되는 순간 멈춘다
Duplicate Weedout은 일단 다 조인해놓고 나중에 거릅니다. FirstMatch는 다른 방향입니다. 이너 테이블을 스캔하다가 매칭되는 로우를 하나 찾으면, 그 값 그룹에 대해서는 더 찾지 않고 즉시 다음으로 넘어갑니다.
SELECT class_num, class_name
FROM class
WHERE class_num IN (SELECT class_num FROM roster);
같은 쿼리라도 FirstMatch로 처리하면, class 로우 하나를 잡고 roster에서 class_num이 일치하는 로우를 찾다가 첫 번째로 매칭되는 로우를 찾는 즉시 그 class 로우를 결과에 추가하고, roster의 나머지 매칭 로우들은 더 보지 않습니다. 원래 서브쿼리를 EXISTS처럼 실행하던 방식과 원리가 비슷합니다.
EXPLAIN의 Extra에는 FirstMatch(tbl_name)로 표시됩니다.
Duplicate Weedout과의 차이
Duplicate Weedout은 불필요한 중복 로우까지 일단 다 만들어낸 다음 걸러내지만, FirstMatch는 애초에 불필요한 로우를 만들지 않습니다. 그래서 조건이 맞을 때는 FirstMatch가 더 효율적입니다. 다만 FirstMatch는 "첫 매칭에서 바로 멈춘다"는 특성 때문에 조인 순서에 제약이 생깁니다. 이너 테이블은 항상 아우터 테이블 뒤에 와야 하고, 순서를 자유롭게 바꿀 수 없습니다.
LooseScan
인덱스로 중복값 자체를 건너뛴다
FirstMatch가 "조인 결과에서 중복을 만들지 않는" 방식이라면, LooseScan은 한 단계 더 앞선 지점, 서브쿼리 테이블을 스캔하는 단계에서부터 중복을 원천적으로 건너뜁니다.
SELECT class_num, class_name
FROM class
WHERE class_num IN (SELECT class_num FROM roster);
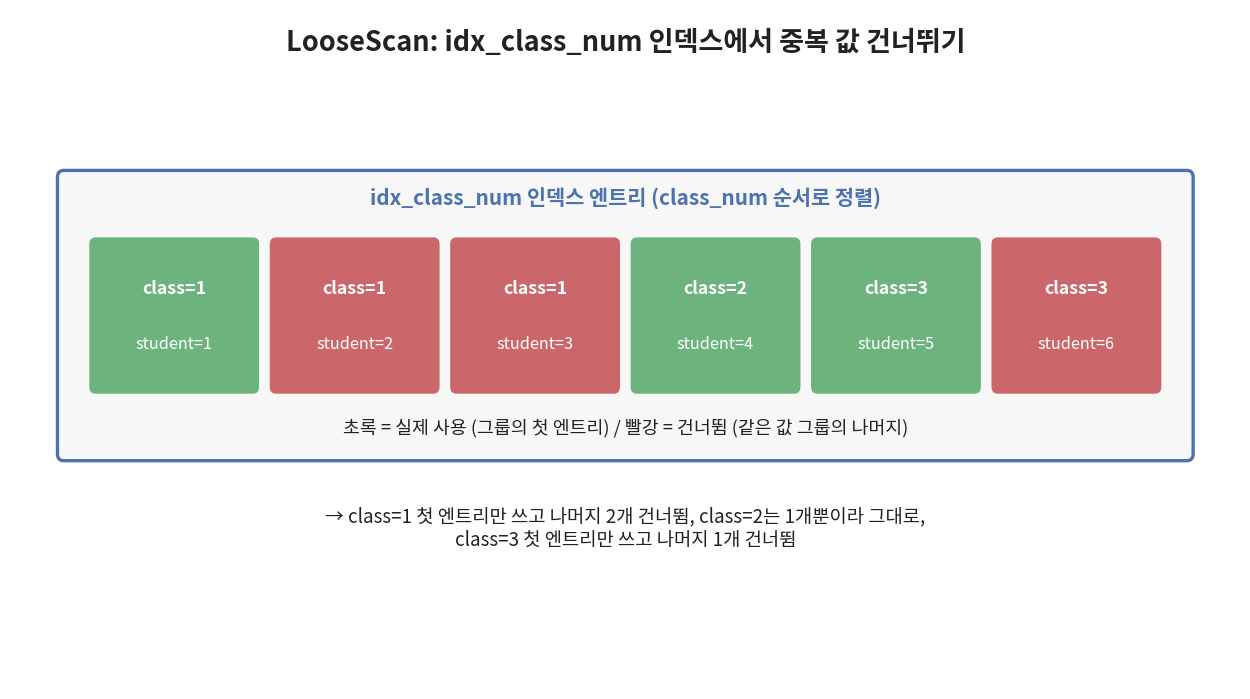
roster.idx_class_num 인덱스는 class_num 값 순서로 정렬되어 있습니다. 같은 class_num 값을 가진 로우들은 인덱스 안에서 서로 붙어 있습니다. LooseScan은 이 인덱스를 스캔하면서, 어떤 class_num 값 그룹을 만나면 그 그룹의 첫 번째 엔트리만 집어서 사용하고, 나머지 같은 값들은 인덱스 탐색으로 건너뛰어 버립니다.
이 방식은 3편에서 다룬 스킵 스캔과 얼핏 비슷해 보이지만 별개의 최적화입니다. 참고로 MySQL 공식 문서에서도 GROUP BY 최적화에 쓰이는 Loose Index Scan과 이름이 비슷해서 혼동하지 말라고 따로 언급합니다. 스킵 스캔과 Loose Index Scan은 "인덱스의 특정 컬럼 조건이 비어 있어도 distinct 값 단위로 건너뛰며 스캔한다"는 원리를 단일 테이블 조회에 적용한 것이고, LooseScan은 같은 "건너뛰기" 원리를 세미조인의 중복 제거에 적용한 것이라고 이해하면 됩니다.
EXPLAIN의 Extra에는 LooseScan(m..n)으로 표시되며, m과 n은 사용된 인덱스의 컬럼 위치를 가리킵니다.
조건
LooseScan은 서브쿼리 테이블의 조인 조건에 사용할 컬럼에 적절한 인덱스가 있어야 성립합니다. 인덱스가 없으면 애초에 "건너뛸" 대상을 찾을 수 없기 때문입니다.
Materialization
서브쿼리를 통째로 임시 테이블로 만든다
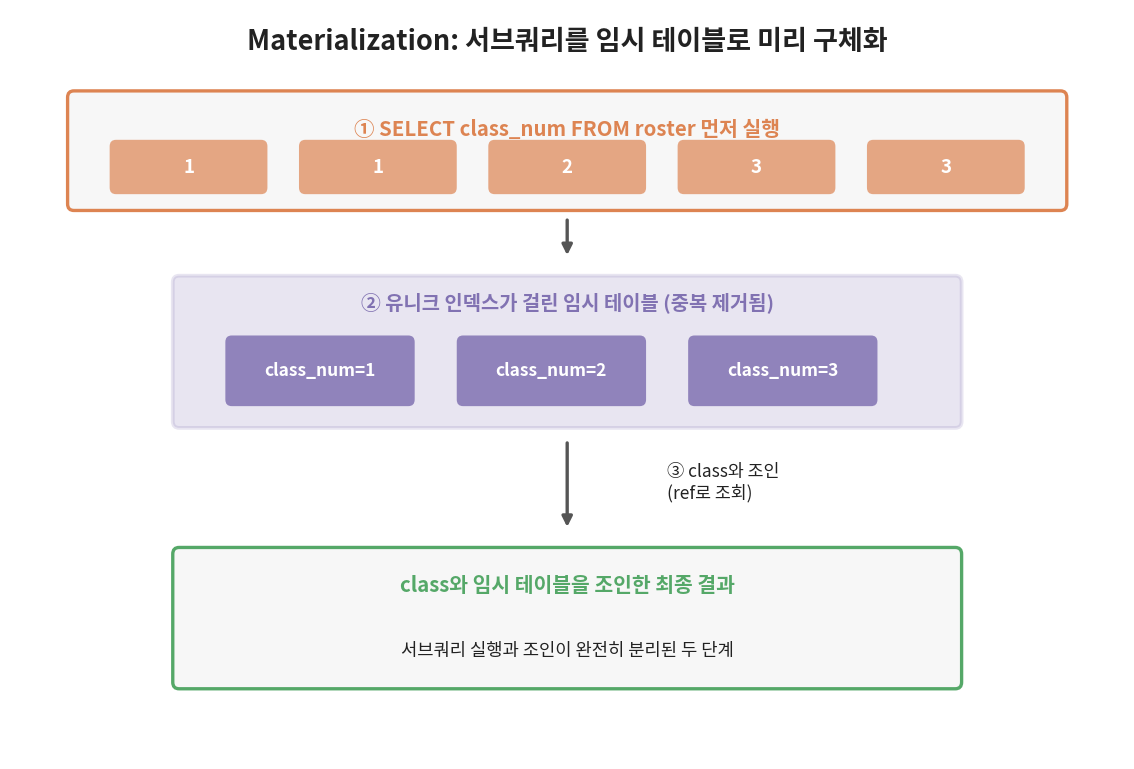
Materialization은 접근 자체가 다릅니다. 서브쿼리를 실행해서 나온 결과를, 중복이 제거된 상태로 임시 테이블에 통째로 저장한 다음, 그 임시 테이블을 아우터 테이블과 조인합니다.
SELECT class_num, class_name
FROM class
WHERE class_num IN (SELECT class_num FROM roster);
서브쿼리 SELECT class_num FROM roster를 먼저 실행해서, class_num 값들을 유니크 인덱스가 걸린 임시 테이블에 저장합니다. 이 유니크 인덱스 자체가 중복 제거 역할을 합니다. 그다음 class 테이블을 이 임시 테이블과 조인합니다. 임시 테이블에 인덱스가 있으니 class의 각 로우에 대해 이 임시 테이블을 ref 방식으로 빠르게 조회할 수 있고, 상황에 따라 반대로 임시 테이블을 스캔하면서 class를 찾아가는 방향으로도 조인할 수 있습니다.
EXPLAIN에서는 select_type이 MATERIALIZED로 표시되는 별도의 행과, 테이블 이름이 <subqueryN> 형태로 표시되는 행으로 나타납니다.
다른 전략들과의 근본적인 차이
Duplicate Weedout, FirstMatch, LooseScan은 모두 서브쿼리와 아우터 테이블을 어떤 형태로든 한 번의 조인 과정 안에서 처리합니다. Materialization은 이와 달리 서브쿼리 실행과 조인을 완전히 분리된 두 단계로 나눕니다. 서브쿼리 결과가 크지 않고 여러 번 재사용할 수 있는 상황이라면, 이렇게 미리 다 구해놓고 인덱스로 빠르게 조회하는 게 유리할 수 있습니다.
정리
| Table Pullout | Duplicate Weedout | FirstMatch | LooseScan | Materialization | |
| 중복 제거 시점 | 필요 없음 (원천적으로 중복 불가능) | 조인 다 끝난 뒤 | 매칭 즉시 (조인 도중) | 서브쿼리 인덱스 스캔 도중 | 조인 시작 전 (서브쿼리 실행 시) |
| 방법 | 서브쿼리 테이블을 아우터 쿼리로 끌어내 평범한 조인으로 전환 | 임시 테이블에 PK 기록 후 유니크 인덱스로 거름 | 첫 매칭에서 바로 다음으로 이동 | 인덱스에서 중복 값 그룹을 건너뜀 | 결과를 유니크 인덱스가 있는 임시 테이블로 구체화 |
| 필요 조건 | 조인 조건 컬럼이 PK/유니크 인덱스 | 없음 (범용적) | 조인 순서 제약 있음 | 서브쿼리 조인 컬럼에 인덱스 필요 | 없음 |
| EXPLAIN 표시 | 세미조인 흔적 없음 (평범한 조인처럼 보임) | Start temporary / End temporary |
FirstMatch(tbl) |
LooseScan(m..n) |
select_type: MATERIALIZED |
다섯 전략은 옵티마이저 스위치 duplicateweedout, firstmatch, loosescan, materialization(모두 기본 on)으로 개별 제어할 수 있고, /*+ SEMIJOIN(strategy) */, /*+ NO_SEMIJOIN(strategy) */ 힌트로 쿼리 단위로도 강제하거나 배제할 수 있습니다. Table Pullout만은 별도 스위치가 없고 semijoin 플래그 전체에 종속됩니다. 옵티마이저는 적용 가능한 전략들의 비용을 비교해서 하나를 고르며, 특별한 설정이 없다면(그리고 Table Pullout 조건도 안 맞는다면) Duplicate Weedout이 최후의 보루로 남습니다.
다음 편에서는 옵티마이저가 조건을 평가하기 전에 그 조건이 얼마나 로우를 걸러낼지 추정하는 컨디션 팬아웃 필터와, 서브쿼리·뷰·CTE를 외부 쿼리에 병합할지 임시 테이블로 구체화할지를 결정하는 파생 테이블 병합을 다루겠습니다.
'Data > MySQL' 카테고리의 다른 글
| [MySQL] 고급 최적화 (3) - 단일 테이블에서 인덱스를 더 잘 쓰는 법: ICP, 인덱스 확장, 인덱스 머지, 스킵 스캔 (0) | 2026.07.06 |
|---|---|
| [MySQL] 고급 최적화 (2) - 조인은 어떻게 실행되는가: Hash Join과 세 전략의 종합 비교 (0) | 2026.07.05 |
| [MySQL] 고급 최적화 (1) - 조인은 어떻게 실행되는가: BNL, MRR & BKA (0) | 2026.07.05 |
| [MySQL] 정렬과 그룹핑 처리 - filesort, 임시 테이블, 그리고 그 내부 (0) | 2026.06.13 |
| [MySQL] B-Tree 인덱스 완전 해부 — 구조부터 가용성까지 (1) | 2026.06.07 |


