들어가며
[이전 편: BNL, MRR & BKA]에서는 Nested Loop Join의 기본적인 한계, 그리고 그 한계를 각자 다른 방식으로 풀어낸 Block Nested Loop(BNL)와 BKA(+ MRR)를 다뤘습니다.
https://dmoritle.tistory.com/266
[MySQL] 고급 최적화 (1) - 조인은 어떻게 실행되는가: BNL, MRR & BKA
들어가며지금까지 이 시리즈에서는 MySQL 서버의 구조와 InnoDB의 내부 동작을 다뤘습니다. 서버 레이어의 커넥션 처리와 쿼리 처리 파이프라인, 그리고 버퍼 풀과 인덱스 구조, 로그 시스템까지 In
dmoritle.tistory.com
두 전략 모두 "드리븐 테이블에 대한 접근을 어떻게 다룰 것인가"에 초점을 맞추고 있었죠. 그리고 이전 편 마지막에 짚었듯, BNL은 MySQL 8.0.20부터 서버에서 완전히 제거되었습니다.
이번 편에서는 그 자리를 대신 차지한 Hash Join을 다룹니다. Hash Join은 접근 횟수나 I/O 패턴을 개선하는 게 아니라, 비교 연산 자체의 알고리즘 복잡도를 줄이는 전략입니다. 그리고 이 전략이 어떻게 등가 조건뿐 아니라 BNL이 담당했던 모든 경우(부등가 조건, 세미조인, 안티조인, 아우터 조인)까지 흡수하게 되었는지도 함께 살펴보겠습니다. 마지막으로 지금까지 다룬 세 전략(BNL, BKA, Hash Join)을 한 번에 정리하며 옵티마이저가 실제로 이들 중 무엇을 선택하는지 정리하겠습니다.
Hash Join
왜 등장했는가
BNL의 근본적인 한계는 "비교를 무차별적으로 한다"는 점이었습니다. 드라이빙 테이블 로우 N개와 드리븐 테이블 로우 M개가 있다면, BNL은 이 조합을 사실상 N × M번 비교합니다.
그런데 조인 조건이 등가 조건(a.col = b.col)이라면, 훨씬 효율적인 방법이 있습니다. 바로 해시 테이블입니다. Hash Join은 이 아이디어를 적용한 전략으로, MySQL 8.0.18부터 도입되어 기본적으로 활성화되어 있습니다. 처음에는 "조인 조건에 등가 조건이 하나라도 있고, 그 조건에 적용할 수 있는 인덱스가 없는 경우"에 한해 사용되었습니다. 즉 도입 초기에는 등가 조건이 있는 경우의 BNL을 대체하는 역할로 시작했습니다.
동작 방식: Build와 Probe
Hash Join은 두 단계로 나뉩니다.
Build 단계: 두 테이블 중 더 작은(또는 옵티마이저가 더 작다고 판단한) 쪽을 골라, 조인 키를 기준으로 메모리에 해시 테이블을 만듭니다. 이 테이블을 build 테이블이라고 부릅니다.
Probe 단계: 나머지 테이블(probe 테이블)의 로우를 하나씩 읽으면서, 그 로우의 조인 키 값으로 해시 테이블을 조회합니다. 매칭되는 값이 있으면 결과에 추가합니다.
[Build 단계]
작은 테이블의 각 로우에 대해:
    해시 테이블[조인 키] = 로우

[Probe 단계]
큰 테이블의 각 로우에 대해:
    해시 테이블에서 조인 키로 조회
    매칭되면 결과에 추가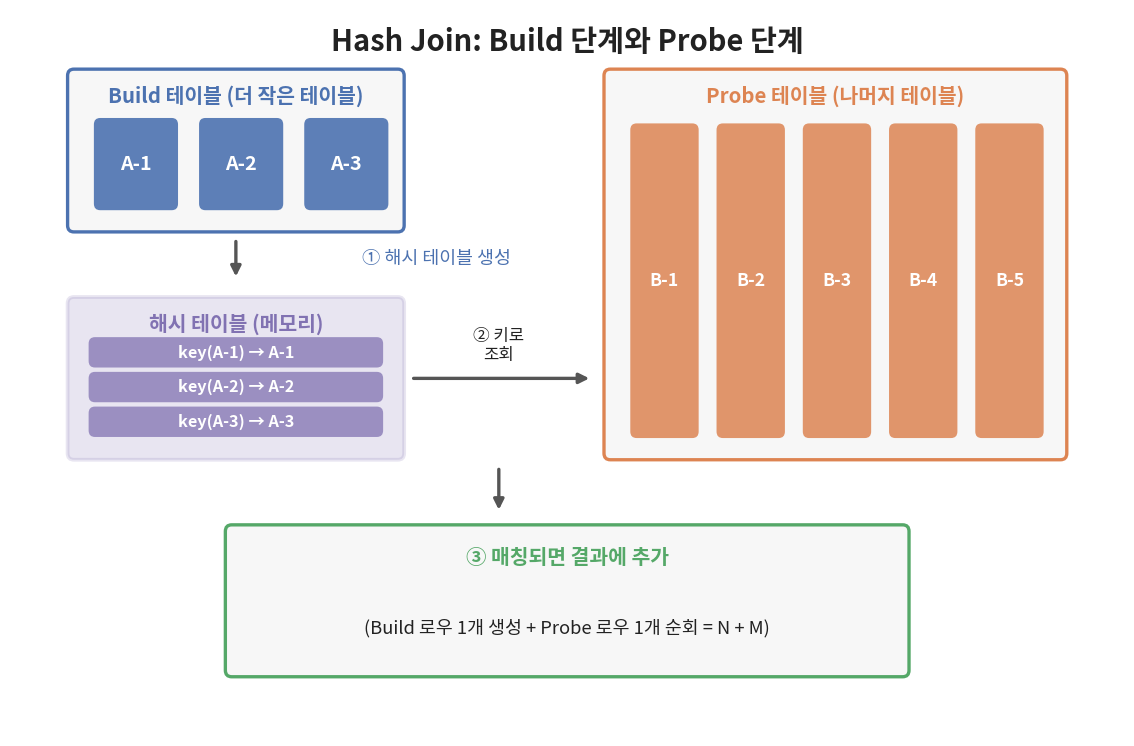
등가 조건에서: 왜 BNL보다 빠른가
BNL에서 비교 연산의 총량이 N × M이었던 것과 비교하면, Hash Join은 이론적으로 build 단계에서 N(또는 M), probe 단계에서 M(또는 N)만큼의 작업만 필요합니다. 즉 전체 작업량이 N × M에서 N + M 수준으로 줄어드는 것입니다. 이는 해시 테이블의 조회가 평균적으로 상수 시간(O(1))에 가깝기 때문에 가능한 결과입니다.
다만 이 속도 이점은 등가 조건이 실제로 해시 키로 쓰일 수 있을 때만 성립합니다. 조인 조건에 등가 조건이 없다면 어떻게 될지가 다음 이야기입니다.
등가 조건이 없는 경우: MySQL 8.0.20의 변화
여기서부터가 흥미로운 지점입니다. MySQL 8.0.20 이전에는 조인 조건에 등가 조건이 하나도 없으면 Hash Join을 쓸 수 없었고, 이 경우 BNL이 담당했습니다. 그런데 MySQL 8.0.20부터는 등가 조건이 없어도 Hash Join이 사용됩니다. 부등가 조건은 물론이고, 세미조인, 안티조인, 아우터 조인까지 전부 Hash Join으로 처리되도록 확장되었습니다. 바로 이 확장 덕분에 BNL이라는 별도의 실행 경로가 더는 필요 없어져서 서버에서 완전히 제거될 수 있었던 것입니다.
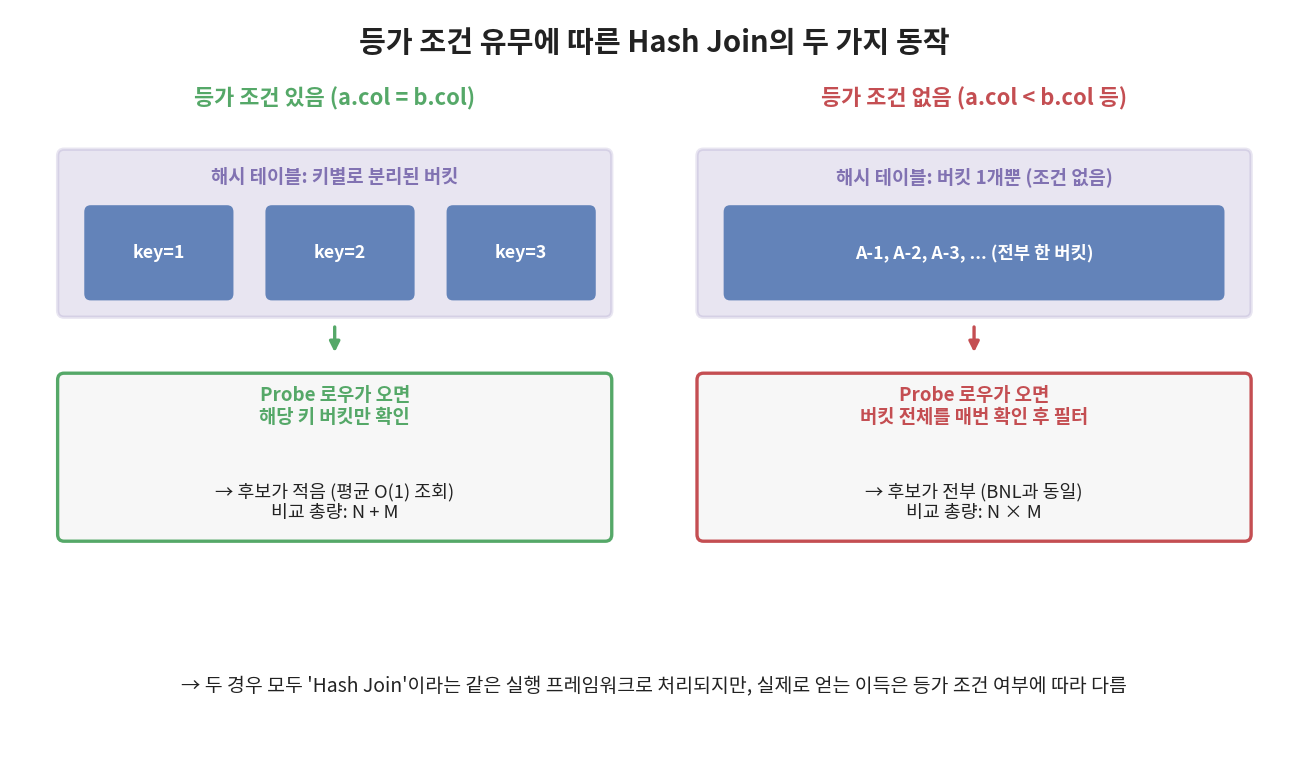
그렇다면 해시 키로 쓸 등가 조건이 없는데, Hash Join은 어떻게 동작할까요? 답은 "조건 없는 해시(hash join with no condition)"입니다. 이 경우 build 테이블의 모든 로우를 그냥 하나의 버킷에 몰아넣는 것과 다름없는 해시 테이블을 만듭니다. 즉 해시 키로 걸러내는 효과는 없고, probe 단계에서 조회하면 그 버킷에 있는 로우 전체가 매번 후보로 나옵니다. 실제 조인 조건(부등가 조건 등)은 이 후보들에 대해 나중에 필터로 적용됩니다.
EXPLAIN FORMAT=TREE로 이런 쿼리를 보면 Inner hash join (no condition)이라는 문구와, 그 위에 별도의 Filter 단계가 붙어 있는 것을 확인할 수 있습니다. 이건 사실 BNL이 하던 일과 본질적으로 같습니다. 한쪽 테이블 로우를 버퍼(해시 테이블)에 모아두고, 반대쪽 로우가 나올 때마다 그 버퍼 전체와 비교(필터링)한다는 점에서요. 달라진 건 이 버퍼링 로직이 이제 BNL이라는 별도 알고리즘이 아니라 Hash Join이라는 하나의 실행 프레임워크 안에 흡수되었다는 점입니다.
정리하면, 등가 조건이 있을 때는 해시 조회로 O(N+M) 수준의 이득을 실제로 얻지만, 등가 조건이 없을 때는 예전 BNL과 똑같이 O(N×M) 비교가 필요합니다. 다만 이제는 그 두 경우 모두 "Hash Join"이라는 하나의 이름 아래 처리된다는 것이 8.0.20 이후의 핵심적인 변화입니다.
메모리를 초과하는 경우
build 테이블이 join_buffer_size보다 커서 해시 테이블이 메모리에 다 들어가지 않는 경우, MySQL은 이를 여러 파티션으로 나누어 처리하는 방식(grace hash join과 유사한 개념)으로 전환합니다. 일부 파티션은 메모리에서 처리하고, 메모리를 초과하는 파티션은 디스크에 임시로 기록한 뒤 다시 읽어와 처리합니다. 이 경우 성능 이점이 줄어들 수 있으므로, join_buffer_size 설정이 Hash Join의 실제 성능에도 영향을 미칩니다. 참고로 MySQL 8.0.20부터는 아우터 조인(세미조인, 안티조인 포함)에도 Hash Join이 쓰이도록 확장되면서, 버퍼를 처음부터 통째로 할당해야 하는 제약도 함께 해소되었습니다.
EXPLAIN으로 확인하기
Hash Join이 사용되는지는 EXPLAIN의 Extra 컬럼에 나오는 Using join buffer (hash join)이라는 문구로 확인할 수 있습니다. 다만 MySQL 8.0.20 이전 버전에서는 일반 EXPLAIN 출력만으로는 Hash Join 여부가 드러나지 않아서, EXPLAIN FORMAT=TREE나 EXPLAIN ANALYZE를 사용해야 했습니다. 조인 조건의 세부 내용(등가 조건인지, 필터가 별도로 붙는지 등)을 자세히 보고 싶다면 지금도 FORMAT=TREE 쪽이 더 유용합니다.
정리: 세 전략 비교
| Block Nested Loop | BKA (+ MRR) | Hash Join | |
| 현재 상태 | MySQL 8.0.20부터 서버에서 완전히 제거됨 | 현재도 사용 가능 (기본은 꺼져 있음) | 현재 기본으로 사용되는 조인 실행 전략 |
| 핵심 아이디어 | 드라이빙 테이블을 버퍼에 모아 드리븐 테이블 스캔 횟수를 줄임 | 조인 키를 모아 MRR로 정렬 후 순차 접근 | 등가 조건을 해시 테이블 조회로 대체 (등가 조건이 없으면 BNL과 동일한 방식으로 동작) |
| 줄이는 대상 | 드리븐 테이블 접근 횟수 | 드리븐 테이블 접근의 I/O 패턴(랜덤 → 순차) | 등가 조건이 있을 때: 비교 연산의 총량 자체 |
| 조인 조건 제약 | 없음 (등가/비등가 모두 가능) | 없음 | 없음 (8.0.20부터 등가 조건 없이도 사용 가능) |
| 드리븐 테이블 인덱스 | 불필요 | 필수 | 불필요 |
세 전략의 관계를 한 문장으로 정리하면 이렇습니다. BKA는 여전히 독립적인 선택지로 남아 있고, BNL은 Hash Join에 완전히 흡수되어 사라졌습니다. 드리븐 테이블에 조인 키로 쓸 인덱스가 있고 그 인덱스를 활용하는 게 유리하다면 BKA가, 그렇지 않다면 Hash Join이 선택됩니다. 그리고 Hash Join 내부에서는 등가 조건의 존재 여부에 따라 실제로 얻는 이득이 달라진다는 점이 이번 편에서 짚은 핵심입니다.
다음 포스트에서는 조인이 아닌 단일 테이블 조회에서의 인덱스 활용 최적화, 즉 Index Condition Pushdown과 인덱스 확장, 인덱스 머지, 스킵 스캔을 다루겠습니다.
https://dmoritle.tistory.com/268
[MySQL] 고급 최적화 (3) - 단일 테이블에서 인덱스를 더 잘 쓰는 법: ICP, 인덱스 확장, 인덱스 머지,
들어가며[1편: BNL, MRR & BKA]와 [2편: Hash Join]에서는 두 개 이상의 테이블을 연결할 때 MySQL이 어떤 알고리즘으로 조인을 실행하는지를 다뤘습니다.https://dmoritle.tistory.com/266 [MySQL] 고급 최적화 (1) -
dmoritle.tistory.com
'Data > MySQL' 카테고리의 다른 글
| [MySQL] 고급 최적화 (4) - IN/EXISTS 서브쿼리는 어떻게 실행되는가: 세미조인 최적화 (0) | 2026.07.06 |
|---|---|
| [MySQL] 고급 최적화 (3) - 단일 테이블에서 인덱스를 더 잘 쓰는 법: ICP, 인덱스 확장, 인덱스 머지, 스킵 스캔 (0) | 2026.07.06 |
| [MySQL] 고급 최적화 (1) - 조인은 어떻게 실행되는가: BNL, MRR & BKA (0) | 2026.07.05 |
| [MySQL] 정렬과 그룹핑 처리 - filesort, 임시 테이블, 그리고 그 내부 (0) | 2026.06.13 |
| [MySQL] B-Tree 인덱스 완전 해부 — 구조부터 가용성까지 (1) | 2026.06.07 |


