들어가며
[1편: BNL, MRR & BKA]와 [2편: Hash Join]에서는 두 개 이상의 테이블을 연결할 때 MySQL이 어떤 알고리즘으로 조인을 실행하는지를 다뤘습니다.
https://dmoritle.tistory.com/266
[MySQL] 고급 최적화 (1) - 조인은 어떻게 실행되는가: BNL, MRR & BKA
들어가며지금까지 이 시리즈에서는 MySQL 서버의 구조와 InnoDB의 내부 동작을 다뤘습니다. 서버 레이어의 커넥션 처리와 쿼리 처리 파이프라인, 그리고 버퍼 풀과 인덱스 구조, 로그 시스템까지 In
dmoritle.tistory.com
https://dmoritle.tistory.com/267
[MySQL] 고급 최적화 (2) - 조인은 어떻게 실행되는가: Hash Join과 세 전략의 종합 비교
들어가며[이전 편: BNL, MRR & BKA]에서는 Nested Loop Join의 기본적인 한계, 그리고 그 한계를 각자 다른 방식으로 풀어낸 Block Nested Loop(BNL)와 BKA(+ MRR)를 다뤘습니다.https://dmoritle.tistory.com/266 [MySQL] 고급
dmoritle.tistory.com
이번 편부터는 초점이 바뀝니다. 조인이 아니라, 테이블 하나를 조회할 때 인덱스를 얼마나 효율적으로 활용하는가에 대한 이야기입니다. 다룰 내용은 네 가지입니다.
- Index Condition Pushdown (ICP): 조건 평가를 스토리지 엔진 레이어로 내려보내는 최적화
- 인덱스 확장 (Index Extension): 세컨더리 인덱스에 암묵적으로 포함된 PK를 활용하는 최적화
- 인덱스 머지 (Index Merge): 여러 인덱스의 스캔 결과를 병합하는 최적화
- 스킵 스캔 (Skip Scan): 복합 인덱스의 선행 컬럼에 조건이 없어도 인덱스를 활용하는 최적화
네 가지 모두 "인덱스가 있는데도 제대로 못 쓰고 있던 상황"을 옵티마이저가 알아서 구제해주는 최적화라는 공통점이 있습니다. 하나씩 살펴보겠습니다.
Index Condition Pushdown (ICP)
레이어 구조 복습
MySQL은 크게 두 레이어로 나뉩니다. 서버 레이어는 SQL을 해석하고 조건을 평가하며 조인을 처리합니다. 스토리지 엔진 레이어(InnoDB 등)는 실제 인덱스와 테이블 데이터를 디스크/버퍼 풀에서 읽어옵니다.
이 구조에서 "조건을 평가하는 일"은 원래 서버 레이어의 책임입니다. 스토리지 엔진은 그냥 요청받은 대로 데이터를 읽어서 넘겨줄 뿐입니다.
ICP가 없다면
세컨더리 인덱스로 조회하는 상황을 생각해보겠습니다.
CREATE TABLE employees (
  id INT PRIMARY KEY,
  last_name VARCHAR(50),
  first_name VARCHAR(50),
  department VARCHAR(50),
  INDEX idx_name (last_name, first_name)
);

SELECT * FROM employees
WHERE last_name = 'Kim' AND first_name LIKE '%Sun%';
인덱스 idx_name(last_name, first_name)은 last_name = 'Kim' 조건까지는 인덱스 탐색으로 바로 활용할 수 있습니다. 하지만 first_name LIKE '%Sun%'은 앞에 와일드카드가 있어서 인덱스만으로 범위를 좁힐 수 없습니다.
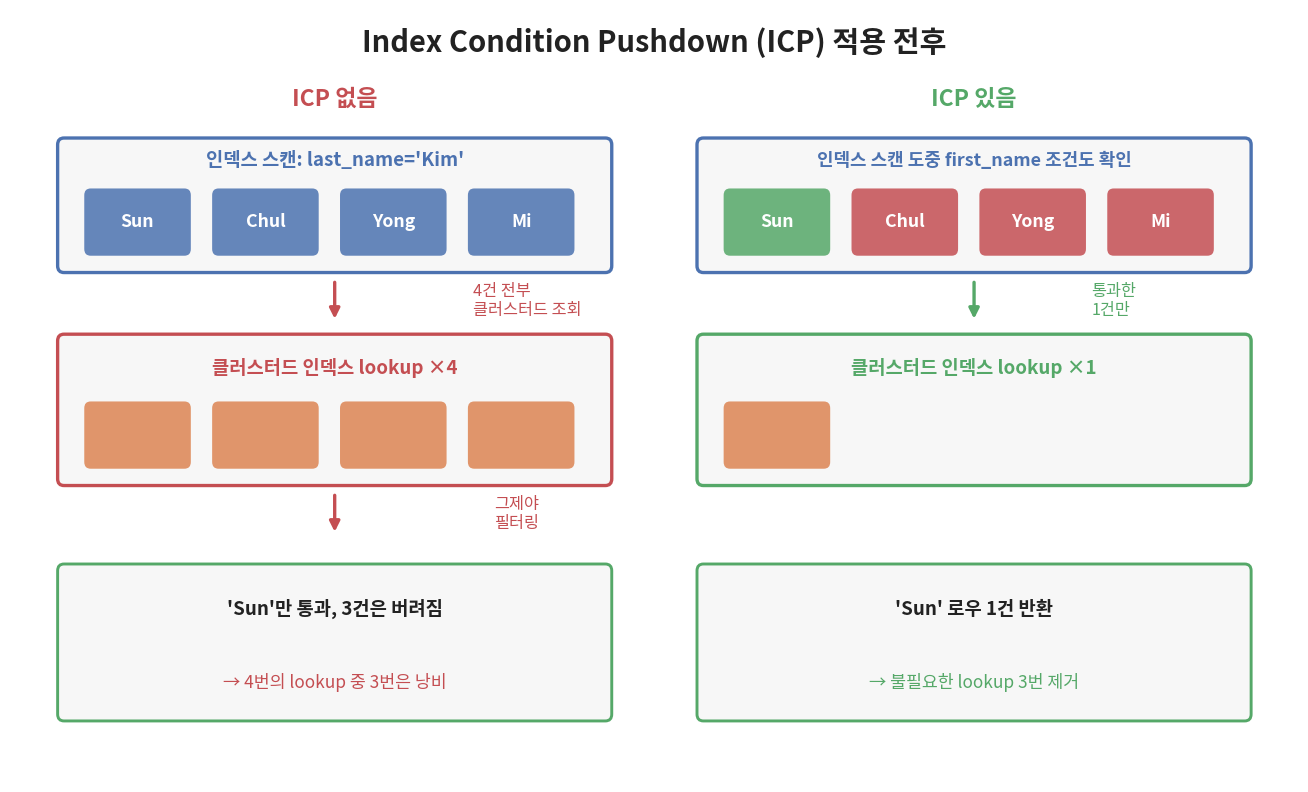
ICP가 없다면 스토리지 엔진은 last_name = 'Kim'에 해당하는 인덱스 엔트리를 찾은 뒤, first_name 조건은 확인하지 않고 일단 PK로 클러스터드 인덱스를 조회해서 전체 로우를 가져옵니다. 그리고서야 서버 레이어가 first_name LIKE '%Sun%' 조건을 평가해서 맞지 않으면 버립니다. last_name = 'Kim'인 사람이 1,000명이고 그중 Sun이 들어간 사람이 5명이라면, 나머지 995번의 클러스터드 인덱스 lookup은 결국 버려질 로우를 가져오기 위한 낭비입니다.
ICP가 하는 일
ICP는 first_name 조건에 대한 평가를, 클러스터드 인덱스 lookup 이전인 인덱스 스캔 도중에 하도록 스토리지 엔진 레이어로 내려보냅니다.
인덱스 idx_name(last_name, first_name)은 first_name 값 자체를 인덱스 엔트리 안에 이미 가지고 있습니다. 그러니 클러스터드 인덱스까지 갈 필요 없이, 인덱스 엔트리만 보고도 first_name LIKE '%Sun%'을 걸러낼 수 있습니다. 조건에 맞지 않으면 그 자리에서 버리고, 클러스터드 인덱스 lookup은 조건을 통과한 엔트리에 대해서만 수행합니다.
조건과 확인 방법
ICP가 적용되려면 해당 조건이 평가에 필요한 컬럼이 전부 그 인덱스에 포함되어 있어야 합니다. 인덱스에 없는 컬럼이 조건에 섞여 있으면 그 부분은 여전히 클러스터드 인덱스까지 가서 서버 레이어에서 평가해야 합니다.
EXPLAIN의 Extra 컬럼에 Using index condition이라는 문구가 보이면 ICP가 적용된 것입니다. optimizer_switch의 index_condition_pushdown 플래그(기본 on)로 켜고 끌 수 있고, NO_ICP 옵티마이저 힌트로 특정 테이블/인덱스에 대해서만 끌 수도 있습니다.
인덱스 확장 (Index Extension)
세컨더리 인덱스는 사실 PK를 숨기고 있다
InnoDB의 세컨더리 인덱스는 검색 대상 컬럼 값과 함께, 클러스터드 인덱스를 다시 찾아가기 위한 PK 값을 항상 같이 저장합니다. 이건 이 시리즈 초반(MRR 편)에서도 다뤘던 내용입니다.
인덱스 확장은 이 사실을 그냥 내부 구현으로만 남겨두지 않고, 옵티마이저가 명시적으로 활용하게 만드는 최적화입니다. 즉 INDEX(a, b)로 선언한 인덱스를, 옵티마이저는 사실상 INDEX(a, b, pk)처럼 취급합니다.
예시로 보는 효과
CREATE TABLE orders (
  id INT PRIMARY KEY,
  customer_id INT,
  status VARCHAR(20),
  INDEX idx_customer (customer_id)
);

SELECT id, customer_id FROM orders
WHERE customer_id = 42
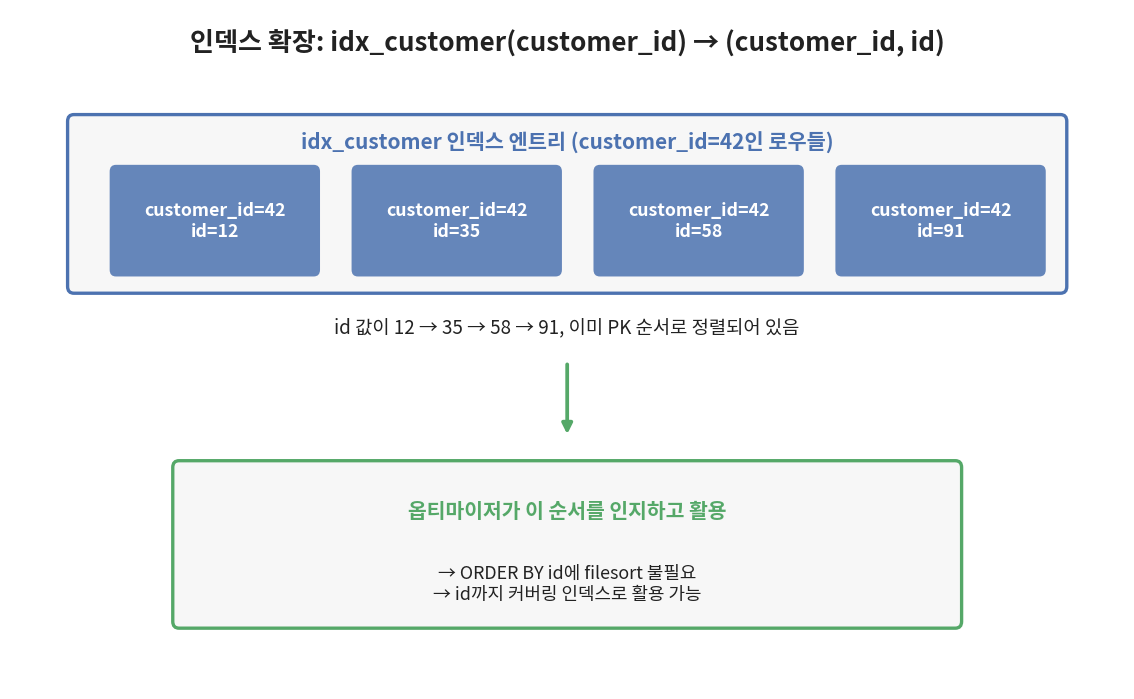
ORDER BY id;idx_customer는 customer_id에 대한 인덱스일 뿐 id에 대한 인덱스가 아닙니다. 그런데 인덱스 확장 덕분에 옵티마이저는 이 인덱스를 실질적으로 (customer_id, id)로 취급할 수 있습니다. customer_id = 42로 좁힌 다음, 같은 인덱스 안에서 이미 id(PK) 순서로 정렬되어 있는 걸 그대로 활용해서 별도의 filesort 없이 정렬된 결과를 낼 수 있습니다.
이 예시는 커버링 인덱스로도 이어집니다. SELECT id, customer_id가 필요한 컬럼이 전부 customer_id와 (확장으로 포함된) id뿐이라, 클러스터드 인덱스까지 갈 필요 없이 idx_customer 인덱스만으로 쿼리가 끝납니다.
확인 방법
use_index_extensions 옵티마이저 스위치(기본 on)로 켜고 끌 수 있습니다. 끄면 옵티마이저가 세컨더리 인덱스에 PK가 암묵적으로 포함되어 있다는 사실을 활용하지 않게 되므로, 위 예시 같은 경우 정렬을 위해 별도의 filesort가 필요해집니다. EXPLAIN에서 key_len이 인덱스에 선언한 컬럼들의 길이 합보다 크게 나온다면, PK 부분까지 포함되어 확장된 것입니다.
인덱스 머지 (Index Merge)
기본 아이디어
지금까지는 "인덱스 하나를 더 잘 쓰는" 이야기였습니다. 인덱스 머지는 조건이 여러 컬럼에 걸쳐 있고, 그 컬럼들에 각각 다른 인덱스가 있을 때, 여러 인덱스를 각각 스캔한 다음 그 결과를 병합하는 최적화입니다.
인덱스 머지에는 세 가지 알고리즘이 있습니다.
Intersection: AND 조건의 교집합
CREATE TABLE t1 (
  id INT PRIMARY KEY,
  key1 INT,
  key2 INT,
  INDEX idx_key1 (key1),
  INDEX idx_key2 (key2)
);

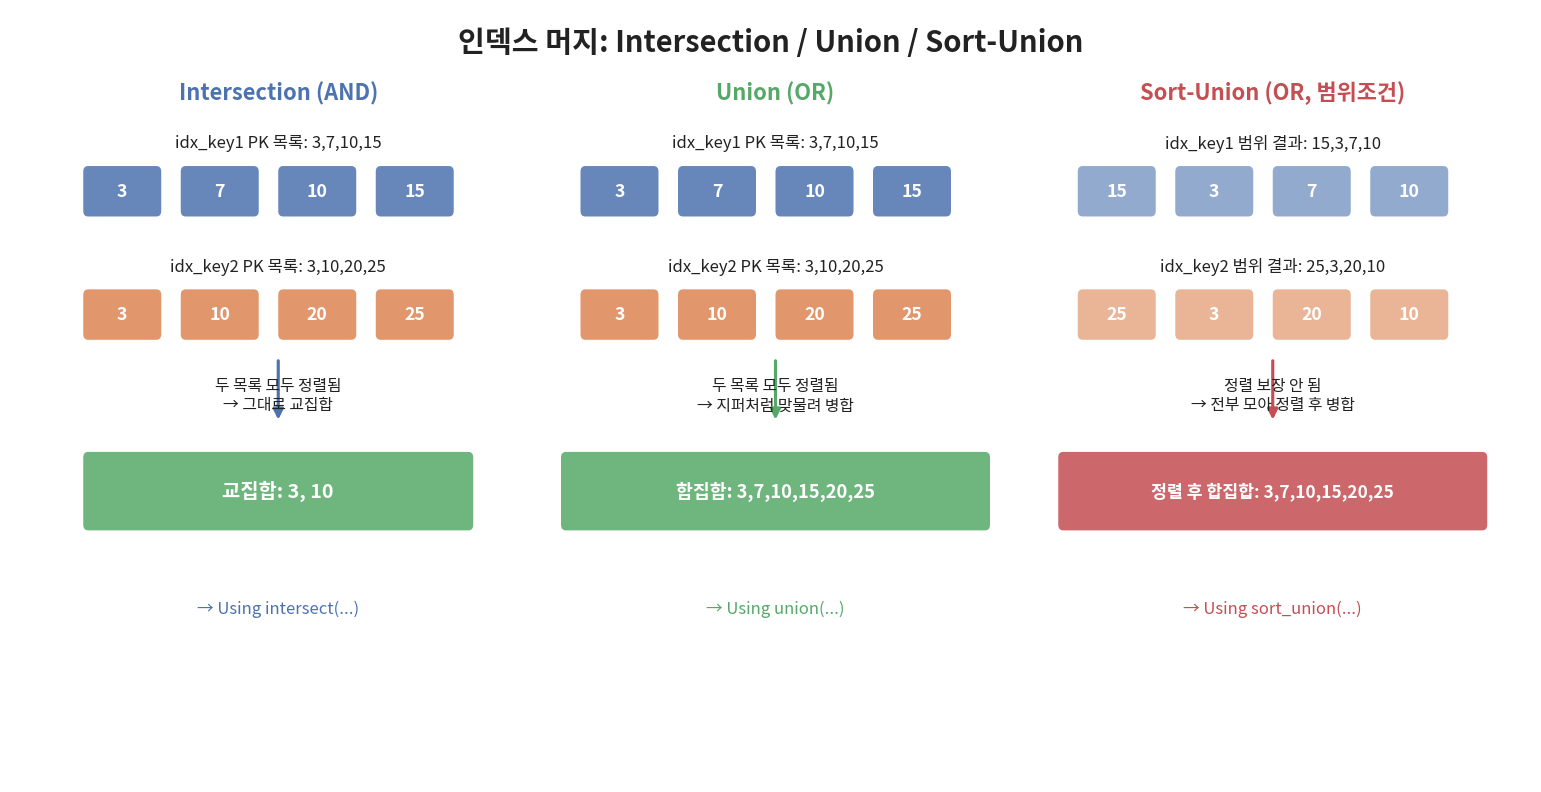
SELECT * FROM t1 WHERE key1 = 20 AND key2 = 30;key1과 key2에 각각 독립된 인덱스가 있고 복합 인덱스는 없습니다. 이 경우 옵티마이저는 idx_key1로 key1 = 20인 로우들의 PK 목록을, idx_key2로 key2 = 30인 로우들의 PK 목록을 각각 얻은 다음, 두 PK 목록의 교집합만 실제로 테이블에서 가져옵니다.
이 알고리즘이 성립하려면 AND로 묶인 각 조건이 (1) 해당 인덱스의 모든 컬럼을 등가로 매칭하거나, (2) InnoDB PK에 대한 레인지 조건이어야 합니다. 두 인덱스 스캔 결과가 PK 순서로 정렬되어 있다는 성질(Rowid-Ordered Retrieval)을 이용해서, 별도 정렬 없이 바로 교집합을 구합니다. EXPLAIN의 Extra에는 Using intersect(idx_key1,idx_key2)로 나타납니다.
Union: OR 조건의 합집합
SELECT * FROM t1 WHERE key1 = 20 OR key2 = 30;OR로 묶인 조건이고, 각 조건이 Intersection과 동일한 기준(인덱스 전체 컬럼 등가 매칭, 또는 PK 레인지)을 만족하면 Union 알고리즘이 적용됩니다. 여기에는 (key1 = 1 AND key2 = 2) OR key3 = 3처럼 Intersection이 적용 가능한 하위 AND 조건이 OR로 묶인 경우도 포함됩니다
이런 경우 Union이 여러 개의 Intersection 결과를 다시 합치는 "교집합들의 합집합" 형태로 동작합니다. 두 인덱스 스캔 결과 모두 이미 PK로 정렬되어 있으므로, 정렬 없이 그대로 병합하면서 중복된 PK만 걸러내면 됩니다. Extra에는 Using union(idx_key1,idx_key2)로 나타납니다.
Sort-Union: 정렬이 필요한 합집합
SELECT * FROM t1 WHERE key1 < 20 OR key2 < 30;이번엔 등가 조건이 아니라 범위 조건입니다. key1 < 20처럼 부등호로 걸리는 범위 조건은 Union이 요구하는 기준(인덱스 전체 컬럼 등가 매칭)을 만족하지 못합니다. 이 경우에도 인덱스 머지 자체는 가능하지만, 각 인덱스 스캔 결과가 PK 순서로 깨끗하게 정렬되어 있다는 보장이 없기 때문에, PK 값들을 전부 모아서 정렬한 다음 합쳐야 합니다. 이게 Sort-Union입니다. Extra에는 Using sort_union(idx_key1,idx_key2)로 나타납니다.
Union과 Sort-Union의 차이는 결국 "이미 정렬된 두 줄을 그냥 지퍼처럼 맞물려 합치느냐(Union), 아니면 일단 다 모아서 한 번 정렬하고 합치느냐(Sort-Union)"의 차이입니다.
확인 방법과 한계
EXPLAIN의 type 컬럼에 index_merge로 표시되고, key 컬럼에는 사용된 인덱스 목록이 나열됩니다. optimizer_switch의 index_merge, index_merge_intersection, index_merge_union, index_merge_sort_union 플래그(모두 기본 on)로 제어할 수 있습니다.
인덱스 머지는 어디까지나 하나의 테이블 안에서 여러 인덱스를 병합하는 최적화이고, 전문 검색(FULLTEXT) 인덱스에는 적용되지 않습니다. 그리고 애초에 조건에 맞는 컬럼들을 하나의 복합 인덱스로 만들 수 있다면, 그게 인덱스 머지보다 대체로 더 빠릅니다. 인덱스 머지는 "복합 인덱스를 만들기 애매한 상황"에 대한 차선책으로 이해하는 게 맞습니다.
스킵 스캔 (Skip Scan)
선행 컬럼 조건이 없으면 원래 인덱스를 못 쓴다
복합 인덱스 (f1, f2)가 있을 때, WHERE f1 = ... AND f2 = ...처럼 선행 컬럼부터 조건이 있으면 인덱스를 그대로 씁니다. 하지만 다음처럼 선행 컬럼 조건이 아예 없으면 어떻게 될까요?
CREATE TABLE t1 (
  f1 INT,
  f2 INT,
  INDEX idx_f1_f2 (f1, f2)
);

SELECT f1, f2 FROM t1 WHERE f2 > 40;f1에 대한 조건이 없으니 인덱스 (f1, f2)를 레인지 스캔으로 쓸 수 없습니다. MySQL 8.0.13 이전이라면 이 경우 인덱스 풀 스캔이나 테이블 풀 스캔으로 처리됐습니다.
스킵 스캔이 하는 일
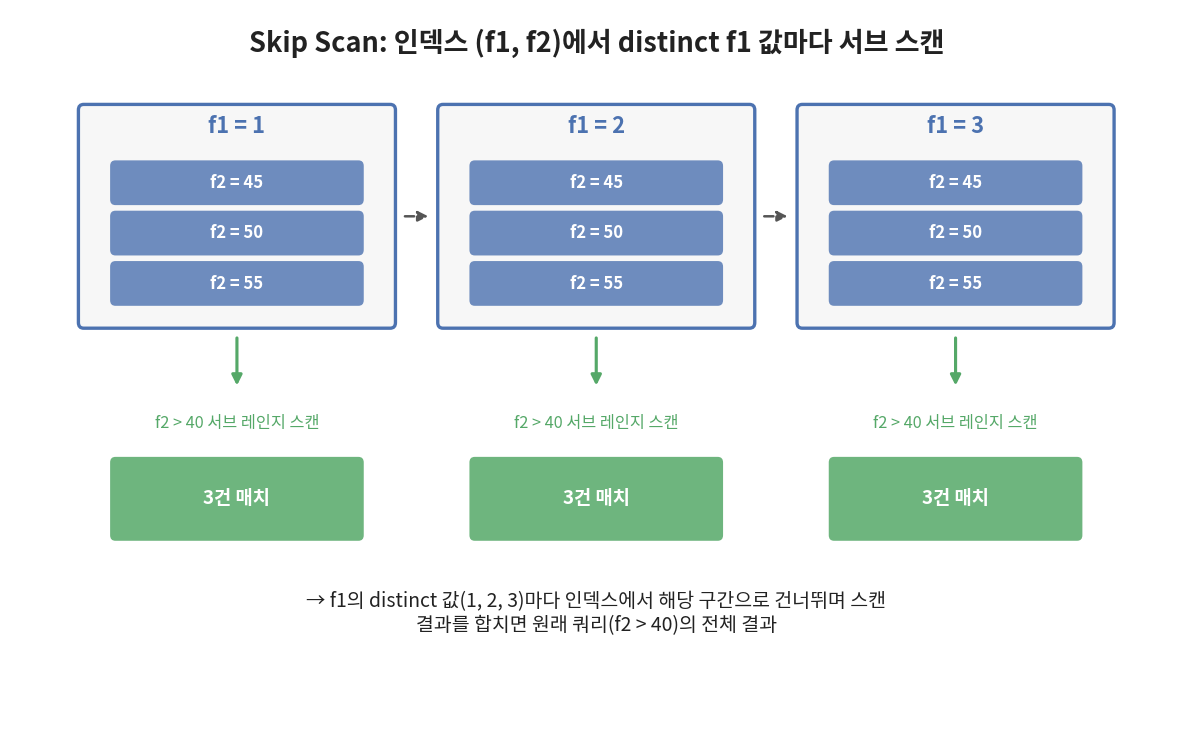
MySQL 8.0.13부터는 f1의 distinct 값이 적다면, 그 값들을 하나씩 순회하면서 각각에 대해 f2 조건으로 서브 레인지 스캔을 하는 방식을 씁니다. 이름 그대로, f1 값들 "사이를 건너뛰며(skip)" 스캔하는 것입니다.
f1이 1, 2, 3 세 가지 값만 가진다면, 스킵 스캔은 다음과 같이 동작합니다.
1. f1 = 1로 좁히고, f2 > 40 범위 스캔
2. f1 = 2로 좁히고, f2 > 40 범위 스캔
3. f1 = 3으로 좁히고, f2 > 40 범위 스캔
이 세 번의 서브 스캔 결과를 합치면 원래 쿼리의 결과가 됩니다. f1의 distinct 값 개수가 적을수록 이 방식이 유리하고, distinct 값이 너무 많으면 서브 스캔 횟수가 늘어나서 오히려 손해이므로 옵티마이저가 비용을 계산해서 선택합니다.
Loose Index Scan과의 관계
이 방식은 이 시리즈의 정렬/그룹핑 편에서 다뤘던 GROUP BY의 Loose Index Scan과 원리가 같습니다. Loose Index Scan도 인덱스의 특정 prefix 값마다 필요한 부분만 건너뛰며 훑는 방식이었죠. 차이는 Loose Index Scan은 GROUP BY/집계 상황에, 스킵 스캔은 WHERE 조건에서 선행 컬럼이 비어 있는 일반적인 상황에 적용된다는 점입니다.
확인 방법과 조건
EXPLAIN의 Extra에 Using index for skip scan이 나타나고, possible_keys에 해당 인덱스가 후보로 표시됩니다. optimizer_switch의 skip_scan 플래그(기본 on)로 제어하며, SKIP_SCAN/NO_SKIP_SCAN 옵티마이저 힌트로 특정 테이블·인덱스 단위로도 제어할 수 있습니다.
정리
이번 편에서 다룬 네 가지는 모두 "인덱스에 원래 담겨 있던 정보를 옵티마이저가 더 적극적으로 활용하는" 최적화라는 공통점이 있습니다.
- ICP: 인덱스 엔트리에 있는 값으로 조건을 먼저 걸러서, 불필요한 클러스터드 인덱스 lookup을 줄임
- 인덱스 확장: 세컨더리 인덱스에 암묵적으로 포함된 PK를 정렬·커버링에 활용
- 인덱스 머지: 복합 인덱스가 없을 때, 여러 단일 인덱스의 스캔 결과를 교집합/합집합으로 병합
- 스킵 스캔: 복합 인덱스의 선행 컬럼 조건이 없어도, distinct 값이 적으면 인덱스를 우회적으로 활용
다음 편에서는 세미조인 최적화(Materialization, Duplicate Weedout, FirstMatch, LooseScan)를 다루겠습니다.
'Data > MySQL' 카테고리의 다른 글
| [MySQL] 고급 최적화 (4) - IN/EXISTS 서브쿼리는 어떻게 실행되는가: 세미조인 최적화 (0) | 2026.07.06 |
|---|---|
| [MySQL] 고급 최적화 (2) - 조인은 어떻게 실행되는가: Hash Join과 세 전략의 종합 비교 (0) | 2026.07.05 |
| [MySQL] 고급 최적화 (1) - 조인은 어떻게 실행되는가: BNL, MRR & BKA (0) | 2026.07.05 |
| [MySQL] 정렬과 그룹핑 처리 - filesort, 임시 테이블, 그리고 그 내부 (0) | 2026.06.13 |
| [MySQL] B-Tree 인덱스 완전 해부 — 구조부터 가용성까지 (1) | 2026.06.07 |


