들어가며
지금까지 이 시리즈에서는 MySQL 서버의 구조와 InnoDB의 내부 동작을 다뤘습니다. 서버 레이어의 커넥션 처리와 쿼리 처리 파이프라인, 그리고 버퍼 풀과 인덱스 구조, 로그 시스템까지 InnoDB의 핵심 메커니즘을 살펴봤습니다.
이번 포스트부터는 조금 다른 층위의 이야기를 다룹니다. 지금까지 살펴본 구조들이 "데이터를 어떻게 저장하고 관리하는가"에 대한 답이었다면, 이번 시리즈는 "그 저장된 데이터를 어떻게 더 빠르게 조합해서 결과를 만들어내는가", 즉 옵티마이저의 고급 최적화 기법들을 다룹니다.
첫 번째 주제는 조인(Join)입니다. 정확히는, 두 개 이상의 테이블을 연결할 때 MySQL이 실제로 어떤 알고리즘으로 실행하는가에 대한 이야기입니다. 같은 조인이라도 실행 방식에 따라 성능이 몇 배씩 차이가 날 수 있는데, 이 시리즈에서는 그 차이를 만드는 세 가지 전략—Block Nested Loop(BNL), MRR과 결합된 BKA(Batched Key Access), 그리고 Hash Join—을 두 편에 나누어 살펴보겠습니다. 이번 편에서는 BNL과 MRR, BKA까지 다루고, 다음 편에서 Hash Join과 세 전략의 종합 비교를 다룹니다.
이 순서는 우연이 아닙니다. 실제로 MySQL의 조인 실행 전략은 이 순서대로 발전해 왔습니다. 각 전략이 어떤 문제를 풀기 위해 등장했는지를 따라가다 보면, 왜 최신 MySQL(8.0.20 이상)에서는 BNL이라는 실행 경로 자체를 볼 수 없는지도 자연스럽게 이해하실 수 있을 것입니다.
조인의 기본 문제: Nested Loop Join의 한계
모든 이야기는 가장 단순한 조인 알고리즘인 Nested Loop Join(NLJ)에서 시작합니다.
두 테이블 A(드라이빙 테이블)와 B(드리븐 테이블)를 조인한다고 가정하겠습니다. NLJ는 이름 그대로 반복문이 중첩된 형태로 동작합니다.
for each row a in A:
    for each row b in B:
        if a와 b가 조인 조건을 만족하면:
            결과에 추가
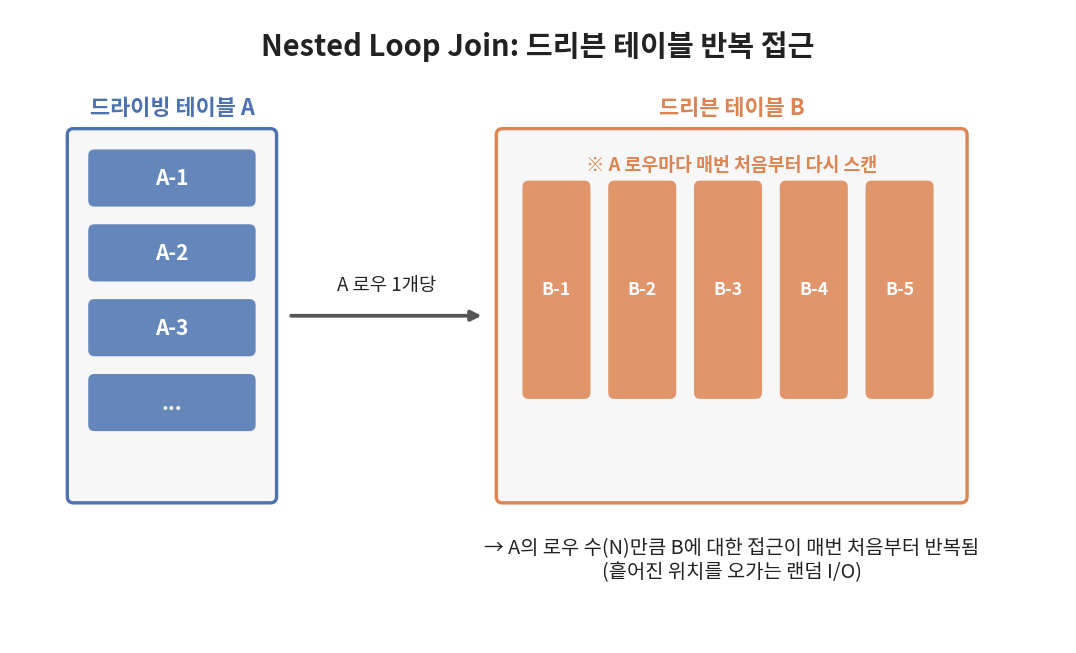
여기서 중요한 건, 바깥쪽 반복문이 한 번 돌 때마다 안쪽 반복문, 즉 드리븐 테이블에 대한 접근이 매번 처음부터 다시 일어난다는 점입니다. 드리븐 테이블에 조인 조건에 맞는 인덱스가 없다면 이 접근은 풀 테이블 스캔이 되고, 인덱스가 있다면 인덱스를 이용한 조회가 됩니다.
문제는 인덱스를 사용하더라도 발생합니다. 드라이빙 테이블의 로우 수가 N이라면, 드리븐 테이블에 대한 접근은 최소 N번 일어납니다. 이 접근들은 대부분 흩어진 위치를 개별적으로 찾아가는 랜덤 I/O입니다. 드라이빙 테이블의 로우가 많아질수록 이 랜덤 I/O의 총 횟수도 그만큼 늘어나고, 디스크 기반 스토리지에서는 이것이 조인 성능의 가장 큰 발목을 잡는 요인이 됩니다.
여기서 두 가지 서로 다른 방향의 해법이 등장합니다.
- 드리븐 테이블에 대한 반복 접근 자체를 줄이자 → Block Nested Loop
- 드리븐 테이블에 대한 접근을 랜덤이 아닌 순차적인 형태로 바꾸자 → MRR과 BKA
이번 편에서는 이 두 방향을 순서대로 따라가 보겠습니다.
Block Nested Loop (BNL)
조인 버퍼가 하는 일
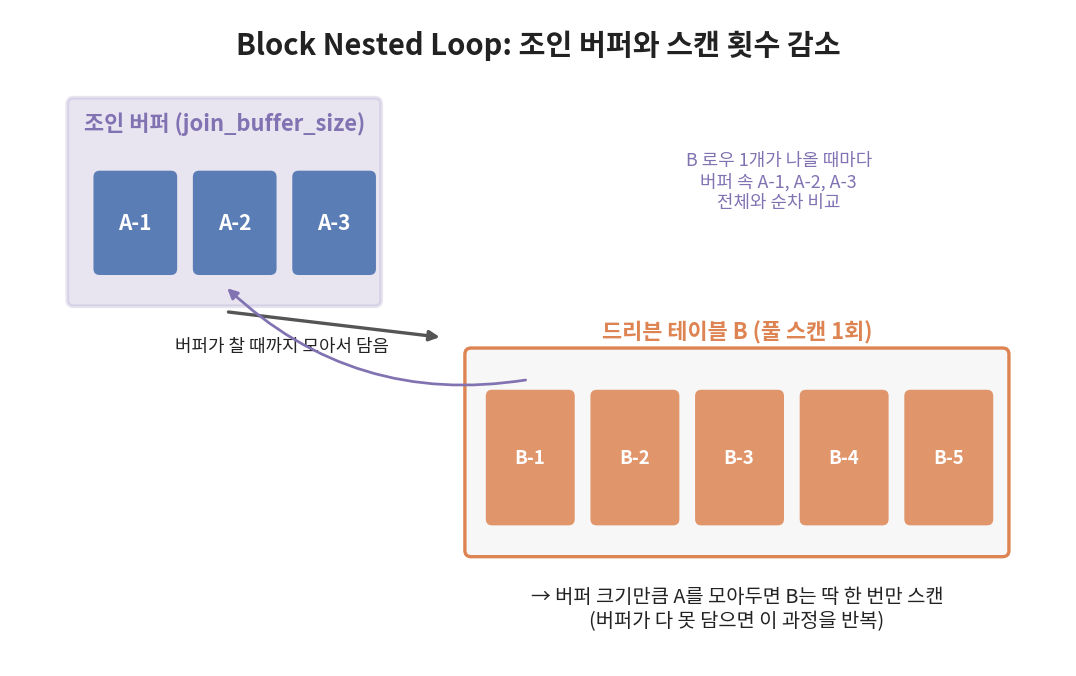
Block Nested Loop은 "드리븐 테이블에 대한 접근 횟수를 줄이자"는 방향의 해법입니다. 핵심 아이디어는 단순합니다. 드라이빙 테이블의 로우를 하나씩 흘려보내는 대신, join_buffer_size만큼 여러 개를 메모리 버퍼(조인 버퍼)에 모아둔 다음, 드리븐 테이블을 딱 한 번 스캔하면서 흘러나오는 로우 하나하나를 버퍼에 쌓인 로우 전체와 비교하는 것입니다.
이때 조인 버퍼에는 로우 전체가 저장되는 것이 아니라, 조인 조건과 결과 산출에 필요한 컬럼만 저장됩니다. 메모리를 아끼기 위한 장치입니다.
구체적인 숫자로 살펴보겠습니다. 드라이빙 테이블 A가 1,000개 로우, 드리븐 테이블 B가 100개 로우를 가지고 있다고 가정합니다.
순수 NLJ라면: A의 로우 1,000개 각각에 대해 B를 매번 접근해야 하므로, B에 대한 접근이 1,000번 발생합니다.
BNL이라면: 조인 버퍼에 A의 로우 300개가 들어간다고 가정하면, B를 스캔해야 하는 횟수는 ceil(1000 / 300) = 4번으로 줄어듭니다. B에 대한 접근 총량은 4 × 100 = 400번입니다.
비교 연산 자체의 총량은 두 방식 모두 동일하게 A×B, 즉 100,000번입니다. 줄어드는 건 B에 대한 접근(스캔) 횟수입니다. 비교는 이미 메모리에 올라와 있는 데이터끼리 이루어지는 CPU 연산이라 상대적으로 저렴하지만, B에 대한 접근은 디스크 I/O를 수반할 수 있어 훨씬 비쌉니다. BNL은 값싼 비교 연산을 늘리는 대신 비싼 I/O 횟수를 줄이는 트레이드오프를 취하는 전략입니다.
버퍼에 다 담기지 않을 때
join_buffer_size가 드라이빙 테이블 전체를 담기에 충분하지 않다면, 위 과정이 반복됩니다. 버퍼를 채우고 → 드리븐 테이블을 한 바퀴 스캔하고 비교 → 버퍼를 비우고 다음 청크로 다시 채우고 → 드리븐 테이블을 다시 스캔... 이 과정이 드라이빙 테이블을 모두 처리할 때까지 반복됩니다. 즉 버퍼 크기가 클수록 드리븐 테이블의 재스캔 횟수는 줄어들지만, 무한정 키운다고 항상 이득인 것은 아니며 메모리 사용량과의 균형을 고려해야 합니다.
BNL의 한계
BNL은 조인 조건의 종류를 가리지 않고 적용할 수 있다는 장점이 있습니다. 등가 조건(equi-join)이든 부등가 조건(non-equi join)이든 상관없이, 그냥 버퍼에 담긴 값들과 하나씩 비교하면 되기 때문입니다.
다만 바로 이 지점이 약점이기도 합니다. 비교를 무차별적으로(brute-force) 수행하기 때문에, 등가 조건처럼 훨씬 효율적인 자료구조(해시 테이블)를 쓸 수 있는 상황에서도 그 이점을 활용하지 못합니다. 이 문제를 해결한 것이 다음 편에서 다룰 Hash Join입니다.
버전에 따라 이 약점이 실제로 어떻게 처리되었는지가 달라집니다. MySQL 8.0.18에서는 등가 조건이 있는 조인에 대해서만 옵티마이저가 BNL보다 Hash Join을 우선 선택하도록 바뀌었고, 부등가 조건(non-equi join)에는 여전히 BNL이 쓰였습니다.
하지만 MySQL 8.0.20부터는 Hash Join이 부등가 조건까지 처리할 수 있도록 확장되면서, BNL은 서버에서 완전히 제거되었습니다. 즉 이 글에서 설명한 BNL은 MySQL 8.0.20 이전 버전의 조인 실행 방식이며, 최신 MySQL에는 BNL이라는 실행 경로 자체가 존재하지 않습니다. 다만 block_nested_loop라는 옵티마이저 스위치 이름은 8.0.20 이후에도 그대로 남아 있는데, 지금은 이 스위치가 (BNL이 아니라) Hash Join 사용 여부를 제어하는 용도로 의미가 바뀌었습니다.
MRR (Multi-Range Read)
세컨더리 인덱스 조회의 숨은 비용
BNL과는 다른 방향에서 접근하는 최적화가 MRR입니다. 이걸 이해하려면 먼저 세컨더리 인덱스를 이용한 조회가 왜 느릴 수 있는지를 짚어야 합니다.
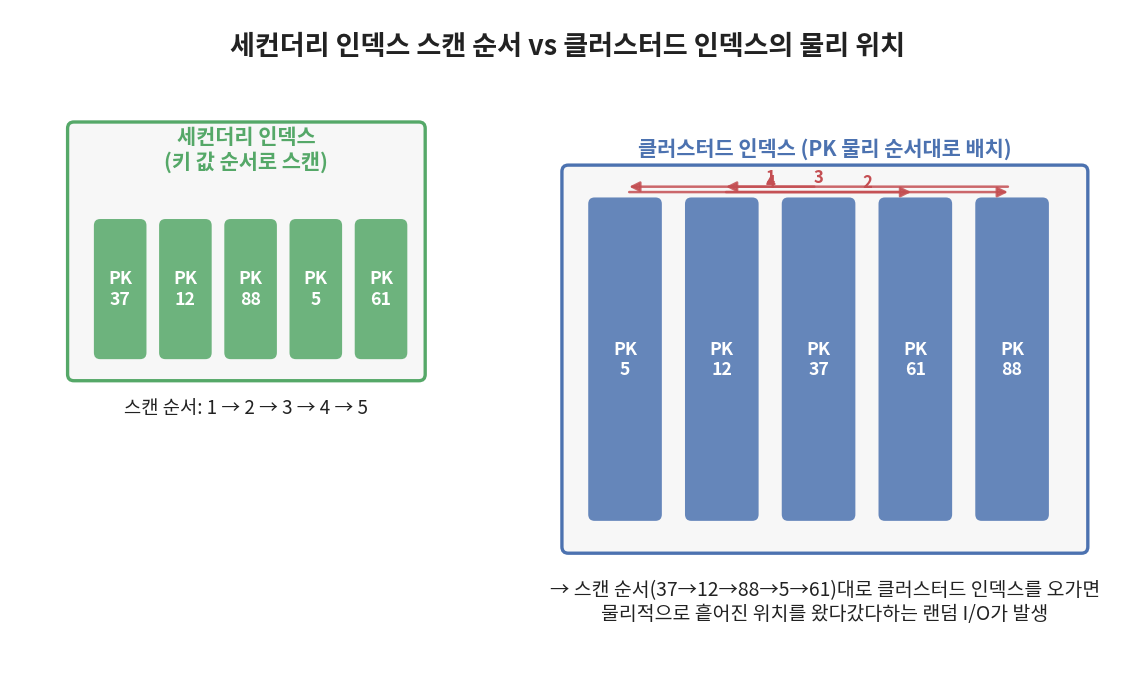
InnoDB에서 세컨더리 인덱스는 인덱스 키와 함께 프라이머리 키(PK) 값을 저장하고 있을 뿐, 실제 로우 데이터를 담고 있지 않습니다. 따라서 세컨더리 인덱스로 조건에 맞는 로우를 찾았다면, 그 로우의 나머지 컬럼 값을 얻기 위해서는 찾아낸 PK 값으로 클러스터드 인덱스(즉, 테이블 자체)를 다시 조회해야 합니다.
문제는 세컨더리 인덱스를 스캔하는 순서와, 그 결과로 얻어지는 PK 값들의 순서가 서로 무관하다는 점입니다. 세컨더리 인덱스는 자신의 키 값 순서로 정렬되어 있을 뿐, PK 값과는 아무 상관이 없습니다. 그 결과 세컨더리 인덱스를 순서대로 읽으면서 얻은 PK 값으로 클러스터드 인덱스를 조회하면, 클러스터드 인덱스 입장에서는 여기저기 흩어진 위치를 오가며 조회하는 랜덤 I/O가 발생합니다.
MRR이 하는 일
MRR의 아이디어는 이 순서를 뒤바꾸는 것입니다. 세컨더리 인덱스에서 PK 값을 얻자마자 바로바로 클러스터드 인덱스를 조회하는 대신, PK 값들을 일정량 모아서 정렬한 뒤에 클러스터드 인덱스를 조회합니다.
정렬된 PK 값 순서로 클러스터드 인덱스에 접근하면, 물리적으로 인접한 위치를 순서대로 훑게 되므로 랜덤 I/O가 순차 I/O에 가까운 형태로 바뀝니다. 순차 I/O는 랜덤 I/O보다 훨씬 빠르기 때문에, 같은 양의 데이터를 읽더라도 전체 소요 시간이 줄어듭니다.
이때 PK 값을 모아두는 공간이 read_rnd_buffer_size로 크기가 결정되는 버퍼입니다. 이 버퍼가 다 차면 그때까지 모인 PK 값을 정렬해서 한 번에 클러스터드 인덱스를 조회하고, 버퍼를 비운 뒤 다음 배치를 또 모으는 과정을 반복합니다.
MRR은 조인이 아닌 단일 테이블 조회에서도 쓰일 수 있는 범용적인 최적화입니다. 다만 MRR의 효과가 가장 두드러지는 곳은 조인, 그중에서도 다음에 다룰 BKA입니다.
BKA (Batched Key Access)
BNL과 MRR을 조인에 결합하기
BKA는 앞서 다룬 두 아이디어, 즉 BNL의 "여러 로우를 모아서 처리한다"는 아이디어와 MRR의 "정렬 후 순차 접근으로 바꾼다"는 아이디어를 조인에 결합한 전략입니다.
동작 방식은 이렇습니다.
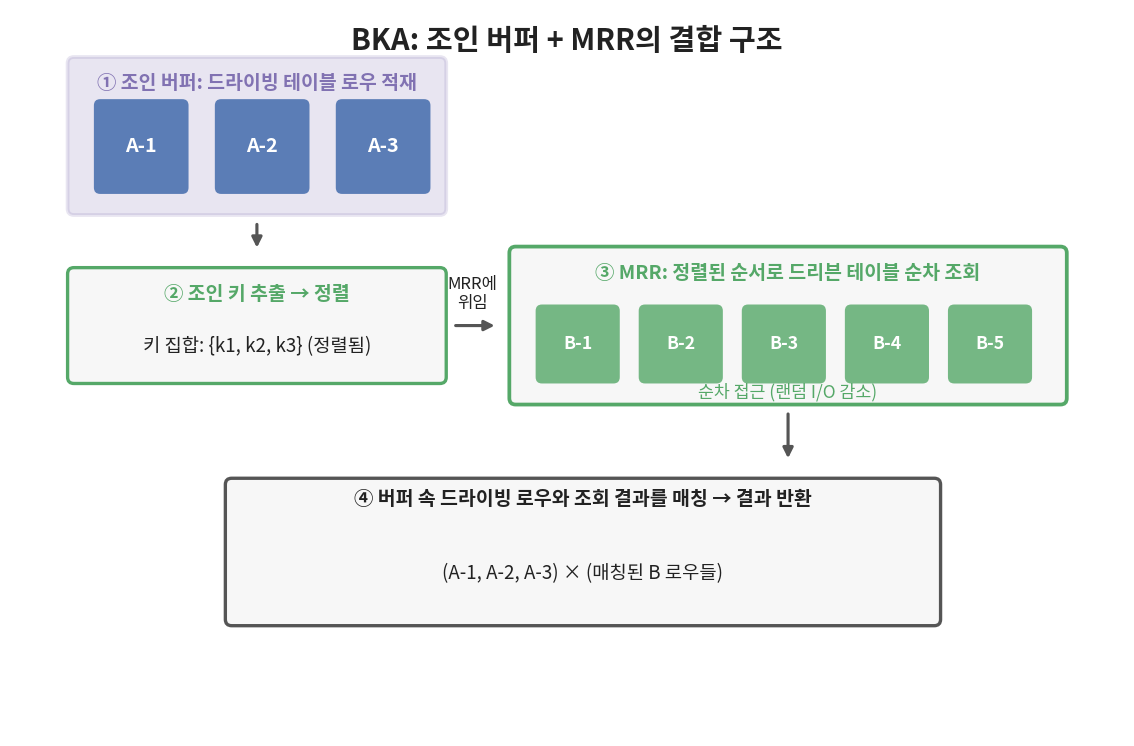
- 드라이빙 테이블의 로우를 조인 버퍼에 모읍니다. (BNL과 동일)
- 버퍼가 차면, 그 로우들에서 드리븐 테이블 인덱스와 매칭될 조인 키 값들을 추출합니다.
- 이 키 값들을 MRR 인터페이스로 넘겨서, 드리븐 테이블에 대한 인덱스 조회를 정렬된 순서로 일괄 처리합니다.
- MRR이 정렬된 순서로 순차적으로 읽어온 로우들을 다시 조인 버퍼의 원래 로우들과 매칭합니다.
BNL과 BKA의 결정적인 차이는 여기 있습니다. BNL은 조인 버퍼에 모인 값을 드리븐 테이블 로우와 직접, 무차별적으로 비교합니다. 반면 BKA는 조인 버퍼에 모인 값을 키의 집합으로 보고, 이 키 집합 전체를 MRR에 넘겨 정렬된 순서로 조회하도록 위임합니다. 즉 BNL의 "모아서 처리" 방식에, MRR의 "랜덤 I/O를 순차 I/O로" 방식을 얹은 것이 BKA입니다.
BKA의 전제 조건
BKA가 성립하려면 필수 조건이 하나 있습니다. 드리븐 테이블에 조인 키로 사용할 인덱스가 존재해야 합니다. MRR 자체가 인덱스 조회를 전제로 한 최적화이기 때문입니다. 인덱스가 없다면 애초에 정렬해서 순차적으로 조회할 대상이 없으므로 BKA를 적용할 수 없고, 이 경우 BNL로 대체됩니다.
BKA는 batched_key_access 옵티마이저 스위치로 켜고 끌 수 있으며, MySQL 8.0 기준 기본값은 꺼져 있습니다. 여기에 실무적으로 자주 놓치는 함정이 하나 있습니다. mrr_cost_based는 기본적으로 켜져 있는데, 이 비용 기반 판단 로직이 MRR/BKA의 이득을 실제보다 낮게 추정하는 경향이 있어서, batched_key_access=on만 켜두면 옵티마이저가 여전히 BKA를 선택하지 않는 경우가 많습니다. 그래서 BKA를 실제로 사용하려면 batched_key_access=on과 함께 mrr_cost_based=off도 설정하는 것이 일반적입니다.
다음 편에서는
BNL과 BKA는 모두 "드리븐 테이블에 대한 접근을 어떻게 다룰 것인가"라는 같은 축 위에 있는 전략이었습니다. 하지만 이 둘에는 공통된 한계가 있습니다. 조인 조건을 만족하는지 확인하기 위해 결국 비교라는 행위 자체를 무차별적으로 수행한다는 점입니다.
다음 편에서는 이 한계를 정면으로 겨냥한 Hash Join을 다룹니다. 등가 조건에서는 비교 연산 자체를 해시 테이블 조회로 대체해버리는 이 전략이 왜, 그리고 얼마나 더 빠른지, 그리고 지금까지 다룬 세 전략을 옵티마이저가 실제로 어떤 기준으로 선택하는지 종합적으로 정리하겠습니다.
https://dmoritle.tistory.com/267
[MySQL] 고급 최적화 (2) - 조인은 어떻게 실행되는가: Hash Join과 세 전략의 종합 비교
들어가며[이전 편: BNL, MRR & BKA]에서는 Nested Loop Join의 기본적인 한계, 그리고 그 한계를 각자 다른 방식으로 풀어낸 Block Nested Loop(BNL)와 BKA(+ MRR)를 다뤘습니다.https://dmoritle.tistory.com/266 [MySQL] 고급
dmoritle.tistory.com
'Data > MySQL' 카테고리의 다른 글
| [MySQL] 고급 최적화 (3) - 단일 테이블에서 인덱스를 더 잘 쓰는 법: ICP, 인덱스 확장, 인덱스 머지, 스킵 스캔 (0) | 2026.07.06 |
|---|---|
| [MySQL] 고급 최적화 (2) - 조인은 어떻게 실행되는가: Hash Join과 세 전략의 종합 비교 (0) | 2026.07.05 |
| [MySQL] 정렬과 그룹핑 처리 - filesort, 임시 테이블, 그리고 그 내부 (0) | 2026.06.13 |
| [MySQL] B-Tree 인덱스 완전 해부 — 구조부터 가용성까지 (1) | 2026.06.07 |
| [MySQL] 트랜잭션과 잠금 2편 — 격리 수준과 MVCC (0) | 2026.06.07 |


