1. 들어가며
지난 편에서 share()와 cache()로 하나의 실행을 여러 구독자가 안전하게 나눠 갖는 법을 봤습니다. 그런데 여기엔 아직 답하지 않은 질문이 하나 남아 있습니다. 구독자가 실행을 공유하든 안 하든, 생산자가 소비자보다 데이터를 빠르게 밀어내면 어떻게 될까요?
Flux.interval(Duration.ofMillis(1))
    .subscribe(i -> {
        slowProcess(i); // 처리에 10ms가 걸린다면?
    });
1ms마다 데이터가 생산되는데 처리에 10ms가 걸린다면, 이 격차는 어디론가 흡수돼야 합니다. 큐에 쌓이거나, 버려지거나, 아니면 터지거나.
실제로 위 코드를 아무 손도 대지 않고 그대로 돌리면 IllegalStateException: Could not emit tick ... due to lack of requests라는 에러와 함께 스트림이 죽어버립니다 — Reactor가 요청량을 넘어선 emit을 그냥 두지 않는다는 뜻입니다.
2편에서 배압을 "왜 필요한가"라는 계약 차원에서 다뤘다면, 이번 편은 Reactor가 실제로 이걸 어떻게 제어하는지 — request(n)이 흐르는 구조부터, 감당 못 할 때 선택할 수 있는 전략들까지 — 실전 관점에서 다룹니다.
2. request(n)이 실제로 흐르는 방식
2편에서 배운 대로, Reactive Streams의 배압은 다운스트림이 업스트림에게 "이만큼 줘"라고 먼저 요청하는 Pull 기반 구조입니다. 그런데 Flux.range(1, 1000).map(...).filter(...).subscribe(...)처럼 연산자가 여러 개 체이닝된 경우, request(n)은 실제로 어떻게 전달될까요?
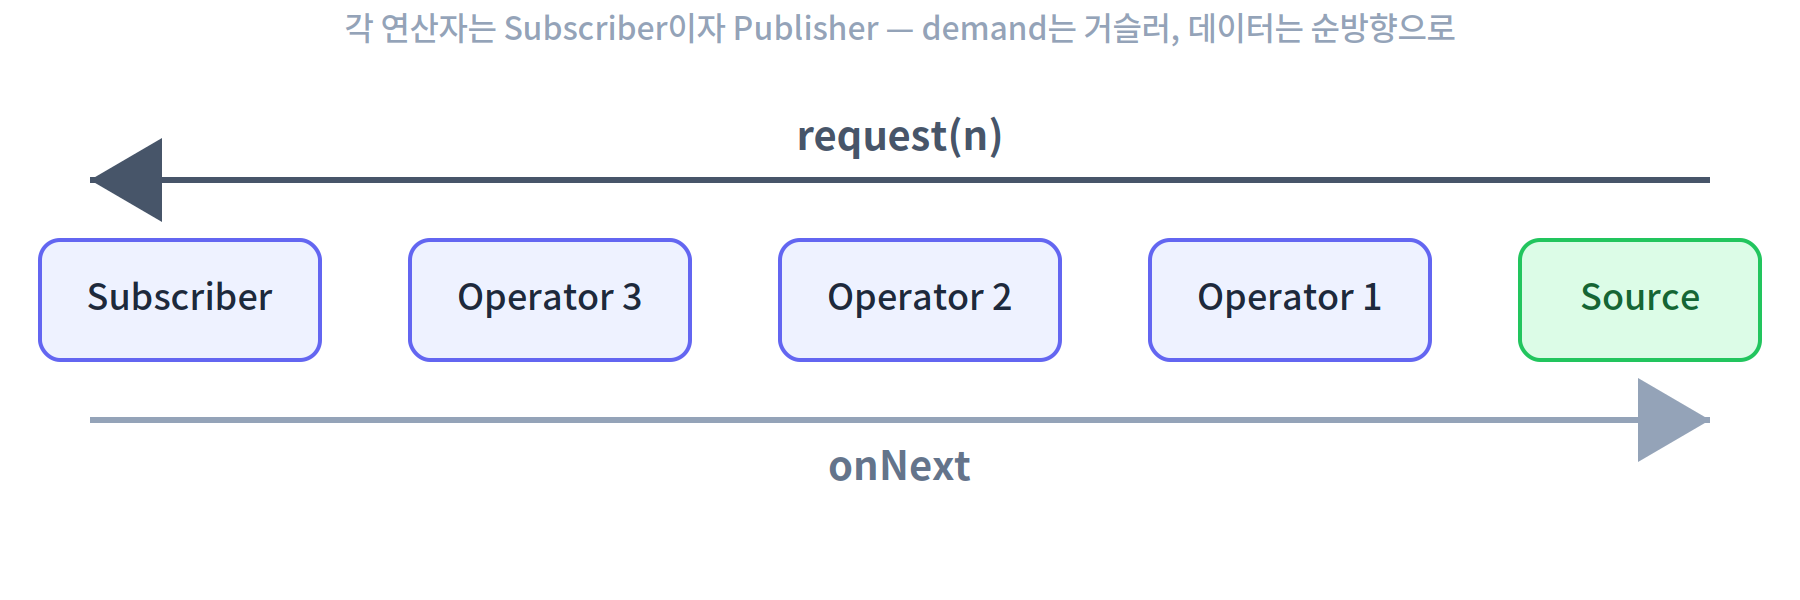
결론부터 말하면, 각 연산자는 자신도 하나의 Subscriber이자 Publisher입니다. subscribe()가 요청한 demand는 체인을 거슬러 올라가며 각 연산자를 통과해 최초 소스까지 전파됩니다.
여기서 실무에 바로 영향을 주는 개념이 하나 있는데, 바로 prefetch입니다. flatMap, publishOn, cache처럼 내부에 큐나 비동기 경계를 두는 연산자들은 다운스트림이 실제로 요청한 개수보다 미리 더 많은 데이터를 업스트림에 요청해 내부 버퍼에 채워둡니다. 기본값은 256입니다.
반면 map, filter처럼 값을 그대로 통과시키기만 하는 연산자는 자체 큐가 없어서 다운스트림의 요청을 그대로 전달할 뿐, prefetch를 적용하지 않습니다.
Flux.range(1, 1000)
    .log() // 실제 request 호출 횟수를 로그로 확인 가능
    .flatMap(Mono::just) // flatMap이 내부 큐를 갖기 때문에 prefetch가 적용됨
.subscribe(i -> {}, e -> {}, () -> {}, sub -> sub.request(1));log()를 걸어 확인해보면, 다운스트림이 request(1)만 호출해도 내부적으로는 request(256)이 먼저 나가는 걸 볼 수 있습니다.
이건 매번 낱개로 요청하는 오버헤드를 줄이기 위한 최적화지만, 동시에 "왜 배압을 걸었는데도 버퍼에 데이터가 쌓이지?"라는 의문의 흔한 원인이기도 합니다. prefetch 자체도 결국 사용자가 조절할 수 있는 값이라는 걸 다음 절에서 확인합니다.
3. 개수 제어 방법
배압이 "요청한 만큼만 받는다"는 계약이라면, 실전에서 그 요청량 자체를 어떻게 조절할지가 관건입니다.
3-1. limitRate(n) — 요청을 잘게 쪼개기
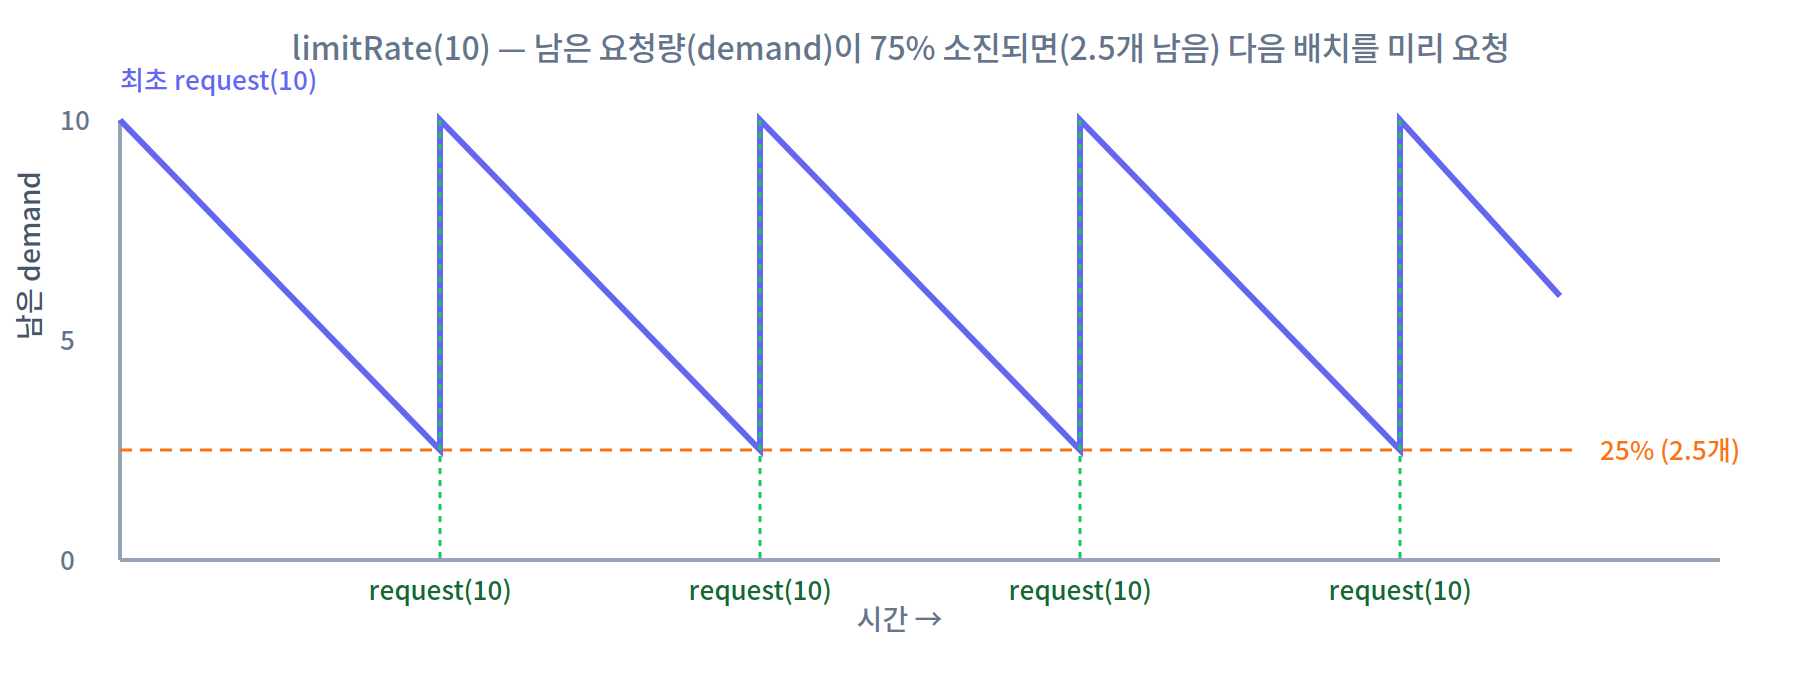
limitRate(n)은 다운스트림이 무제한(Long.MAX_VALUE)으로 요청하더라도, 업스트림에는 n개 단위로 나눠서 요청하도록 강제합니다.
Flux.range(1, 1000)
    .limitRate(10)
    .subscribe(i -> process(i));
이렇게 하면 한 번에 1000개를 몰아서 요청하는 대신, 10개씩 나눠 요청합니다.
내부적으로는 요청량의 75%가 소진되면 다음 배치를 미리 요청하는 방식(low tide replenishing)으로 동작해서, 매번 정확히 10개가 소진될 때까지 기다리지 않고도 끊김 없이 흐름을 유지합니다. limitRate(highTide, lowTide) 형태로 이 재요청 시점을 직접 지정할 수도 있습니다.
3-2. request() 수동 제어 — BaseSubscriber
가장 세밀한 제어는 Subscriber를 직접 구현해 원하는 시점에 원하는 만큼만 request()를 호출하는 것입니다. Reactor는 이를 위해 BaseSubscriber라는 추상 클래스를 제공합니다.
Flux.range(1, 10)
    .subscribe(new BaseSubscriber<Integer>() {
        @Override
        protected void hookOnSubscribe(Subscription subscription) {
            request(2); // 최초에 2개만 요청
        }

        @Override
        protected void hookOnNext(Integer value) {
            log.info("received: {}", value);
            request(1); // 하나 처리할 때마다 하나씩 추가 요청
        }
});hookOnSubscribe에서 첫 요청량을 정하고, hookOnNext에서 처리 하나가 끝날 때마다 다음 요청을 보내는 구조입니다. 이렇게 하면 "내가 처리할 수 있는 만큼만 정확히 요청한다"는 걸 코드로 명시적으로 보장할 수 있습니다.
다만 매 요청마다 수동으로 개입해야 하므로, 대부분의 경우 limitRate나 뒤에서 볼 오버플로우 전략으로 충분하고 이 방식은 정말 세밀한 제어가 필요할 때만 씁니다.
3-3. prefetch 직접 조절하기
3-1(limitRate)과 3-2(BaseSubscriber)는 모두 다운스트림이 상류에 얼마나 요청하느냐를 조절하는 방법이었습니다. 반면 2번 섹션에서 본 prefetch는 이것과 층위가 다릅니다 — flatMap, publishOn처럼 내부에 큐를 둔 연산자 자신이 자기 상류에게 미리 얼마나 요청해둘지를 정하는 값이고, 이 값도 오버로드된 메서드로 직접 지정할 수 있습니다.
// flatMap: concurrency와 prefetch를 함께 지정
Flux.range(1, 1000)
    .flatMap(i -> Mono.just(i), 16, 32) // concurrency=16, prefetch=32
    .subscribe(i -> process(i));

// publishOn: prefetch만 별도로 지정
Flux.range(1, 1000)
    .publishOn(Schedulers.parallel(), 64) // prefetch=64
    .subscribe(i -> process(i));
기본값 256이 너무 크다고 느껴지면(예: 각 원소 처리 비용이 크거나, 리소스 소모가 큰 외부 호출을 감싸는 경우) 이렇게 작은 값으로 줄여서 한 번에 미리 당겨오는 양 자체를 제한할 수 있습니다. 정리하면, "다운스트림이 얼마나 요청하느냐"는 3-1·3-2로, "중간 연산자가 자기 상류에 얼마나 미리 요청해두느냐"는 3-3으로 조절하는 셈입니다 — 둘 다 배압 조절이지만 서로 다른 지점을 건드립니다.
4. 감당 못 할 때의 전략 (Overflow Strategy)
3번의 방법들은 소스가 "요청받은 만큼만 생산"할 수 있다는 전제 위에 있습니다. 하지만 Flux.interval()처럼 다운스트림의 요청과 무관하게 자기 페이스로 값을 밀어내는 소스도 있습니다. 이런 소스는 애초에 request(n) 계약을 지킬 수 없기 때문에, 넘치는 값을 어떻게 처리할지 별도로 정해야 합니다 — 그게 오버플로우 전략입니다.
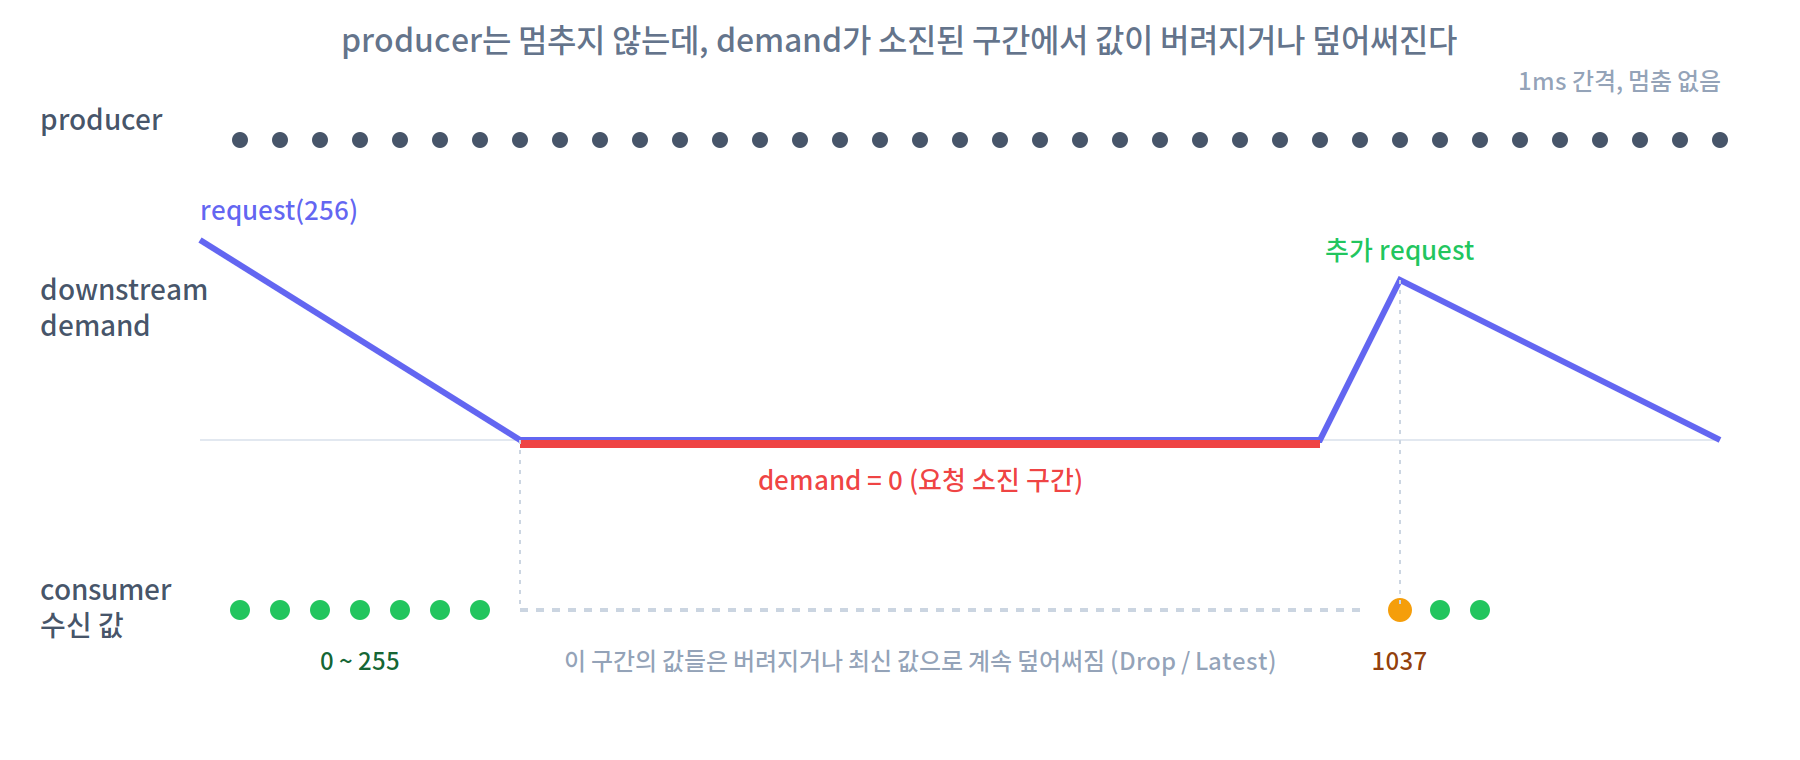
아래 4-2·4-3에서 계속 등장할 "255 다음 갑자기 1037" 같은 점프가 바로 이 타임라인에서 나옵니다 — demand가 바닥난 구간에서 생긴 값들이 전략에 따라 다르게 처리될 뿐, 그 구간 자체는 모든 오버플로우 전략에 공통으로 존재합니다.
4-1. onBackpressureBuffer() — 일단 버퍼에 쌓기
Flux.interval(Duration.ofMillis(1))
    .onBackpressureBuffer(
        1000,
        dropped -> log.warn("buffer full, dropped: {}", dropped),
        BufferOverflowStrategy.DROP_OLDEST
    )
    .subscribe(i -> slowProcess(i));
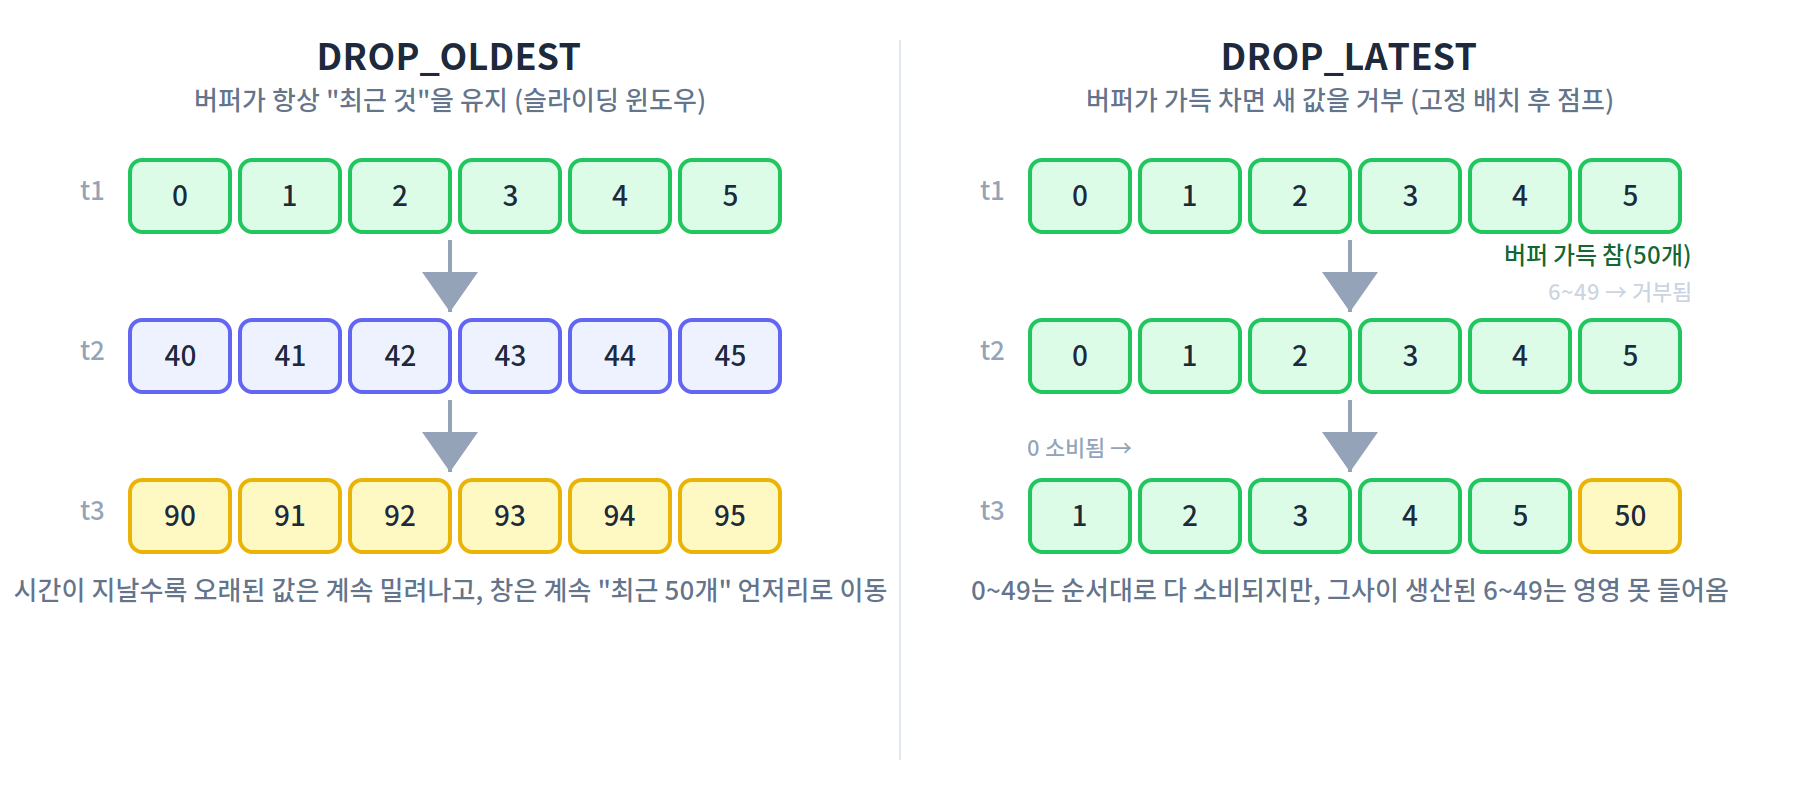
버퍼 크기(1000)를 정해두고 그 안에서 소화될 때까지 데이터를 쌓아둡니다. 버퍼가 가득 찼을 때의 정책도 함께 지정할 수 있는데, DROP_OLDEST(오래된 값부터 버림), DROP_LATEST(새로 들어오는 값을 버림), ERROR(예외 발생) 중 선택합니다. 버퍼 크기를 지정하지 않으면 무제한 버퍼링을 시도하다 메모리를 다 써버릴 위험이 있으니 주의가 필요합니다.
두 정책이 실제로 어떻게 다르게 동작하는지는, 버퍼 크기를 작게 잡고(예: 50) 소비 속도를 의도적으로 느리게 만들어 보면 확실히 드러납니다. (아래 로그는 동작 패턴을 보여주기 위한 예시 값이며, 실제 실행 시 스레드 스케줄링 타이밍에 따라 정확한 숫자는 달라질 수 있습니다.)
DROP_OLDEST
Flux.interval(Duration.ofMillis(1))
    .onBackpressureBuffer(
        50,
        dropped -> log.warn("# dropped(oldest): {}", dropped),
        BufferOverflowStrategy.DROP_OLDEST
    )
    .publishOn(Schedulers.parallel())
    .subscribe(data -> {
        try {
            Thread.sleep(5L);
        } catch (InterruptedException e) {}
        log.info("# onNext: {}", data);
    });

Thread.sleep(2000L);
# onNext: 0
# onNext: 1
# onNext: 2
...
# onNext: 49
# dropped(oldest): 50
# onNext: 56
# dropped(oldest): 57
# onNext: 64
# dropped(oldest): 65
...버퍼가 가득 차는 순간부터는, 새 값이 들어올 때마다 버퍼 안에서 가장 오래된 값을 밀어내고 그 자리를 채웁니다. 그래서 소비자는 처음엔 0부터 순서대로 받다가, 버퍼가 꽉 찬 이후부터는 계속 "그 시점 기준 가장 최근에 살아남은" 값들을 듬성듬성 받게 됩니다. producer가 consumer보다 계속 빠르기 때문에, 받는 값의 번호는 시간이 갈수록 점점 더 크게 건너뛰며 증가합니다 — 버퍼가 항상 "최근 50개 근처"를 유지하려는 방향으로 움직이기 때문입니다.
DROP_LATEST
Flux.interval(Duration.ofMillis(1))
    .onBackpressureBuffer(
        50,
        dropped -> log.warn("# dropped(latest): {}", dropped),
        BufferOverflowStrategy.DROP_LATEST
    )
    .publishOn(Schedulers.parallel())
    .subscribe(data -> {
        try {
            Thread.sleep(5L);
        } catch (InterruptedException e) {}
        log.info("# onNext: {}", data);
    });

Thread.sleep(2000L);
# onNext: 0
# onNext: 1
# onNext: 2
...
# onNext: 49
# dropped(latest): 50
# dropped(latest): 51
# dropped(latest): 52
...
# dropped(latest): 253
# onNext: 254
# onNext: 255
...DROP_LATEST는 버퍼가 가득 차면 새로 들어오는 값을 그냥 버리고, 이미 버퍼 안에 있던 0~49는 그대로 보존합니다. 그래서 소비자는 처음 채워진 50개를 끝까지 순서대로 다 받고(50개 × 5ms ≈ 250ms 소요), 그동안 producer가 새로 만들어낸 값(50~253 근처)은 버퍼에 자리가 없어 전부 버려집니다. 50개를 다 비우고 나서야 버퍼에 다시 자리가 생기고, 그 시점에 생산되고 있던 값부터 다시 쌓이기 시작합니다.
즉 DROP_OLDEST는 "항상 최신을 놓치지 않고 따라가는" 쪽이고, DROP_LATEST는 "이미 받아들인 것들은 끝까지 순서대로 처리하되, 그사이 새로 들어오는 건 놓치는" 쪽입니다. 실제 서비스라면 최근 상태가 중요한 모니터링성 데이터엔 DROP_OLDEST가, 먼저 들어온 요청의 순서 보장이 더 중요한 경우엔(다만 유실 자체는 감수해야 하는 상황이라면) DROP_LATEST가 더 맞는 그림입니다.
여기서 쓰인
DROP_OLDEST/DROP_LATEST는BufferOverflowStrategy라는 별도의 enum입니다. 앞서 4번 도입부 각주에서 본FluxSink.OverflowStrategy(BUFFER, DROP, LATEST, ERROR, IGNORE)와는 다른 타입이에요 — "BUFFER 전략을 선택했을 때, 그 버퍼 자체가 가득 찼을 때 뭘 할지"를 정하는 하위 옵션입니다.이름이 겹쳐 보이지만 동작 층위가 다릅니다.
FluxSink.OverflowStrategy.DROP— 버퍼 없이 새 값을 바로 버림BufferOverflowStrategy.DROP_LATEST— 버퍼는 있되, 그게 가득 찼을 때만 새 값을 버림
4-2. onBackpressureDrop() — 새로 들어오는 값 버리기
버퍼 없이, 다운스트림이 아직 요청하지 않은 상태에서 도착한 값을 그 자리에서 버립니다. 메모리 사용이 거의 없다는 게 장점이고, 유실을 감수할 수 있는 상황에 적합합니다.
Flux.interval(Duration.ofMillis(1))
    .onBackpressureDrop(dropped -> log.warn("# dropped: {}", dropped))
    .publishOn(Schedulers.parallel())
    .subscribe(data -> {
        try {
            Thread.sleep(5L);
        } catch (InterruptedException e) {}
        log.info("# onNext: {}", data);
    });

Thread.sleep(2000L);
# onNext: 253
# onNext: 254
# onNext: 255
# dropped: 256
# dropped: 257
...
# dropped: 1036
# onNext: 1037
# onNext: 1038onBackpressureLatest()와 같은 코드 구조에 연산자만 바꿔서 돌려보면, 255 다음에 1037로 점프하는 지점 자체는 거의 동일하게 재현됩니다 — 두 전략 모두 값을 큐에 쌓아두지 않으니, publishOn의 요청이 소진된 뒤 다시 채워질 때까지의 간격(256~1036)은 똑같이 비어 있습니다.
차이는 그 사이에 무슨 일이 있었는지를 알 수 있느냐에 있습니다. Latest는 값을 조용히 덮어쓸 뿐이라 버려진 값이 몇 개였는지 알 방법이 없지만, Drop은 onBackpressureDrop(Consumer<? super T> onDropped)에 콜백을 넘길 수 있어서 버려지는 값 하나하나를 직접 관찰하거나 카운트할 수 있습니다. 위 로그의 # dropped: 256부터 # dropped: 1036까지가 정확히 781개 — 이만큼의 값이 실제로 유실됐다는 걸 코드로 확인할 수 있다는 게 운영 환경에서는 꽤 중요한 차이입니다. 유실량을 메트릭으로 남기고 싶다면 Drop이, 유실량엔 관심 없고 최신 상태만 중요하다면 Latest가 더 적합한 이유가 여기 있습니다.
4-3. onBackpressureLatest() — 최신 값만 유지
Flux.interval(Duration.ofMillis(1))
    .onBackpressureLatest()
    .publishOn(Schedulers.parallel())
    .subscribe(data -> {
        try {
            Thread.sleep(5L);
        } catch (InterruptedException e) {}
        log.info("# onNext: {}", data);
    });

Thread.sleep(2000L);
# onNext: 253
# onNext: 254
# onNext: 255
# onNext: 1037
# onNext: 1038
...Drop과 비슷해 보이지만 차이가 있습니다. Drop은 새로 들어오는 값을 버리지만, Latest는 항상 "가장 최근 값 하나"는 남겨둡니다. 다운스트림이 다음 값을 요청할 시점엔 중간 값들이 다 버려지고 없더라도 최소한 최신 상태는 받을 수 있습니다.
위 로그에서 255 다음에 256, 257이 아니라 갑자기 1037이 찍히는 게 바로 이 동작을 그대로 보여줍니다. publishOn은 기본 prefetch(256)만큼 처음에 request(256)을 상류로 보내고, Flux.interval(1ms)은 이 256개(0~255)를 눈 깜짝할 새 채워버립니다. 반면 다운스트림은 Thread.sleep(5L) 때문에 256개를 처리하는 데만 1초 이상 걸립니다.
그 사이(요청이 소진된 후, 처리를 못 따라가 재요청이 오기 전까지) interval은 계속 tick을 내고 있고, onBackpressureLatest는 그 값들을 버리는 게 아니라 "최신" 슬롯 하나를 계속 새 값으로 덮어씁니다. publishOn이 처리 진행 상황을 보고 추가 요청을 보내는 순간, 그 시점까지 덮어써진 가장 최근 값이 통과합니다 — 그게 256이 아니라 1037인 겁니다. 즉 256~1036 사이의 값들은 유실된 게 아니라, onBackpressureLatest 입장에서는 애초에 존재한 적조차 없는 셈입니다(마지막에 덮어쓴 값만 살아남으니까요).
4-4. onBackpressureError() — 그냥 실패시키기
Flux.interval(Duration.ofMillis(1))
    .onBackpressureError()
    .subscribe(
        i -> slowProcess(i),
        error -> log.error("overflow 발생", error)
    );
버퍼링도, 유실 허용도 하지 않고 오버플로우가 발생하는 즉시 스트림을 에러로 종료시킵니다. "배압이 걸린다는 것 자체가 설계상 있어서는 안 되는 상황"이라고 판단될 때, 조용히 데이터를 잃는 대신 명시적으로 실패시켜 문제를 조기에 드러내는 용도입니다.
참고로
Flux.create()로 커스텀 소스를 만들 때 쓰는FluxSink.OverflowStrategy에는IGNORE라는 다섯 번째 옵션이 하나 더 있습니다. 공식 문서에 따르면 다운스트림의 배압 요청을 완전히 무시하는 전략이라, 엄밀히는 배압을 처리하는 것이 아니라 배압을 포기하는 옵션에 가깝습니다.
- 위험: 다운스트림 큐가 가득 차면
IllegalStateException이 발생할 수 있습니다.- 기본값 아님:
Flux.create()에 전략을 지정하지 않으면 Reactor는 대신BUFFER(무제한 버퍼링)를 기본으로 적용합니다.- 공통점:
BUFFER도 무제한 버퍼링이라OutOfMemoryError로 이어질 수 있어서, IGNORE와 BUFFER는 동작 방식은 정반대(즉시 밀어넣기 vs 일단 쌓아두기)지만 "한도가 없어서 결국 터질 수 있다"는 위험만큼은 공유합니다.
Flux.create()로 커스텀 소스를 직접 만드는 방법 자체는 이 시리즈에서 깊게 다루지 않을 예정이라 여기서는 각주로만 짚고 넘어갑니다. 다만 다음 편에서 다룰Sinks도 명령형 코드를 리액티브 스트림으로 연결하는 비슷한 목적을 가진 도구라, 배압과 맞닿는 지점은 그때 다시 살펴봅니다.
5. 전략 선택 기준
네 가지 전략은 "유실을 허용할 것인가"와 "메모리를 얼마나 쓸 것인가"라는 두 축으로 정리하면 선택 기준이 명확해집니다.
| 전략 | 유실 여부 | 메모리 특성 | 적합한 상황 |
onBackpressureBuffer |
없음 (또는 정책에 따라 선택적 유실) | 버퍼 크기만큼 사용, 무제한 시 OOM 위험 | 주문 처리, 로그 적재처럼 완전성이 중요한 경우 |
onBackpressureDrop |
있음 (새 값 유실) | 거의 없음 (버퍼 없음) | 유실을 감수해도 되고, 오래된 값 처리가 우선인 경우 |
onBackpressureLatest |
있음 (중간 값 유실, 최신 값만 보존) | 거의 없음 (값 1개만 유지) | 실시간 시세, UI 상태처럼 "최신 상태"만 중요한 경우 |
onBackpressureError |
없음 (즉시 실패) | 없음 | 배압 발생 자체가 이상 징후이며, 조기에 발견해야 하는 경우 |

6. 마무리 및 다음 편 예고
request(n)이 체인을 거슬러 전파되는 구조, prefetch, 그리고 감당 못 할 때의 네 가지 전략까지 봤습니다. 정리하면 배압 제어는 크게 두 단계입니다.
- 얼마나 요청할지 조절하는 것 —
limitRate, 수동request() - 조절이 안 통할 때 무엇을 할지 정하는 것 — 오버플로우 전략
실무에서 원인 모를 메모리 증가나 데이터 유실을 마주쳤을 때, 이 두 단계 중 어디가 빠졌는지 짚어보는 것만으로도 원인을 좁힐 수 있습니다.
다음 편에서는 Sinks를 다룹니다. 지금까지는 Flux.range()나 Flux.interval()처럼 이미 만들어진 소스를 선언형으로 조합하는 데 집중했다면, 실무에서는 외부 콜백이나 이벤트 리스너처럼 명령형 API를 리액티브 스트림으로 직접 밀어넣어야 하는 경우가 많습니다. Sinks.Many/Sinks.One이 바로 이 다리 역할을 하는데, 4편에서 잠깐 등장했던 Sinks.many().multicast().directBestEffort()가 이번 편에서 배운 배압 전략들과 실제로 어떻게 맞물리는지 — 특히 구독자가 없거나 느릴 때 tryEmitNext()가 반환하는 EmitResult로 무슨 일이 일어나는지를 살펴보겠습니다.
'Spring Framework > Spring WebFlux' 카테고리의 다른 글
| [Spring WebFlux] 4편: Cold/Warm/Hot Sequence (1) | 2026.09.15 |
|---|---|
| [Spring WebFlux] 3편: Reactive Streams, 실무에서는 - 구현체와 오해 (0) | 2026.09.14 |
| [Spring WebFlux] 2편: Reactive Streams 스펙 - 계약과 용어 (1) | 2026.09.14 |
| [Spring WebFlux] 1편: 리액티브 프로그래밍이란 무엇인가 (0) | 2026.09.14 |


