1. 들어가며
Spring 프로젝트에서 결제 SDK나 메시징 클라이언트 같은 외부 라이브러리를 붙이다 보면, 가끔 낯선 타입을 마주칩니다. 내 서비스 레이어는 전부 Mono와 Flux로 짜여 있는데, SDK가 반환하는 건 Flowable이나 Observable입니다. Reactor밖에 안 써봤다면 이 시점에서 당황하게 됩니다. 이 둘을 어떻게 같은 체인 안에 섞어야 할까요? 변환이 가능하긴 한 걸까요?
결론부터 말하면 가능합니다. Flowable도, Mono/Flux도, 심지어 Akka Streams의 Source도 결국 2편에서 다룬 Reactive Streams라는 같은 규약 위에서 동작하기 때문입니다. 규약이 같으므로 타입 사이의 변환도 정해진 방법으로 가능합니다.
그런데 정작 그 규약을 이루는 Publisher, Subscriber, Subscription, Processor라는 인터페이스를 실무 코드에서 직접 타이핑해본 기억은 아마 없을 겁니다. Spring 프로젝트에서 실제로 마주치는 건 Flux, Mono, map(), filter() 같은 이름들이지 Publisher.subscribe()가 아닙니다.
이유는 간단합니다. Reactive Streams는 스펙일 뿐, 그 자체로는 아무것도 실행하지 않습니다. JPA가 인터페이스 모음이고 실제 동작은 Hibernate 같은 구현체가 담당하듯, Reactive Streams도 인터페이스와 규칙만 정의하고 실제 스케줄링, 연산자, 성능 최적화는 각 구현체의 몫입니다. 이번 글에서는 이 스펙이 실제로 누구 손에서, 어떻게 구현되어 있는지, 그리고 서로 다른 구현체를 실제로 어떻게 넘나드는지를 짚어보겠습니다.
2. "Data Source"와 "Operator"는 스펙 용어가 아니다
2편까지 오면서 "Data Source"나 "Operator"라는 말을 자연스럽게 써왔을 수도 있습니다. 그런데 이 두 단어, 사실 Reactive Streams 스펙 어디에도 정의되어 있지 않습니다.
"Data Source"는 Flux.just(), Flux.fromIterable()처럼 스트림이 시작되는 지점을 편하게 부르는 실무 용어입니다. 스펙 관점에서 이것도 결국은 그냥 Publisher입니다. 다만 그 Publisher가 스트림의 맨 앞, 즉 다른 Publisher로부터 데이터를 받지 않고 스스로 데이터를 만들어내는 위치에 있을 때, 구분을 위해 "소스"라고 부르는 것뿐입니다.
"Operator"는 map, filter, flatMap 같은 연산자들을 가리키는 말인데, 이것도 스펙에는 없는 용어입니다. 스펙상으로는 이 연산자들이 Processor(Subscriber이면서 동시에 Publisher인 타입)의 역할을 수행하는 것에 가깝습니다. 데이터를 받아서(Subscriber) 가공한 뒤 다시 내보내는(Publisher) 중간 단계이기 때문입니다. Reactor가 이 역할을 개발자가 쓰기 편한 메서드 체이닝 형태로 감싸서 제공한 것이 우리가 아는 map(), filter()입니다.
이 구분이 왜 중요할까요? "Data Source"와 "Operator"는 Reactor나 RxJava 같은 구현체가 개발자 경험을 위해 붙인 이름이지, Reactive Streams가 강제하는 개념이 아니라는 점을 알고 있으면, 다른 구현체로 옮겨갔을 때도 당황하지 않습니다. RxJava에는 "Operator"라는 말이 똑같이 쓰이지만, 스펙 수준에서 보면 결국 둘 다 Publisher, Subscriber, Processor라는 같은 뿌리 위에서 서로 다른 이름표를 붙인 것뿐입니다.
3. 구현체 비교
Reactive Streams를 구현한 라이브러리는 여러 개지만, Spring 생태계 안에서 실무로 직접 다루는 건 사실상 Project Reactor뿐입니다. Mono(0~1)개와 Flux(0~N개)가 핵심 타입입니다. 나머지 셋은 외부 라이브러리를 통해 간접적으로 마주치는 정도이니, Reactor와 다른 점만 짚고 넘어가겠습니다.

- RxJava: 넷플릭스가 만든 원조 격 라이브러리로, 타입이
Flowable/Observable/Single/Maybe/Completable다섯 가지로 더 세분화되어 있습니다. 1.x는 스펙보다 먼저 나와서 브릿지 모듈이 필요했고, 2.x부터 스펙을 직접 구현합니다. 결제 SDK나 안드로이드 라이브러리를 붙이다가Flowable을 마주치는 경우가 여기에 해당합니다. - Akka Streams: 메서드 체이닝이 아니라 액터(Actor) 모델 위에서 동작합니다.
Source/Flow/Sink로 파이프라인을 구성하고,Materializer가 이를 실제로 실행합니다. java.util.concurrent.Flow: Java 9부터 JDK 표준 라이브러리에 포함된 인터페이스 모음입니다. Reactive Streams와 이름만 다른 동일한 4개 인터페이스이고,map/filter같은 연산자나 구현체는 제공하지 않습니다.
4. Spring WebFlux와의 연결
Spring WebFlux는 Project Reactor를 기반으로 합니다. 컨트롤러가 Mono나 Flux를 반환하면 WebFlux 디스패처가 비동기로 응답을 스트리밍합니다. 서버 런타임은 기본값인 Reactor Netty 외에 Tomcat, Jetty, Undertow도 논블로킹 모드로 쓸 수 있지만, 어떤 서버를 쓰든 애플리케이션이 다루는 타입은 동일하게 Mono/Flux입니다.
들어가며에서 던진 질문 — 외부 라이브러리가 Flowable을 반환하면 어떻게 하는가 — 을 실제 코드로 풀면 이렇습니다.
// 결제 SDK가 RxJava의 Flowable을 반환하는 상황
Flowable<PaymentResult> flowable = paymentSdk.charge(request);

// Flowable → Flux: Flowable도 Publisher이므로 그대로 넘길 수 있음
Flux<PaymentResult> flux = Flux.from(flowable);

// 반대로 내 Mono를 RxJava 쪽 API에 넘겨야 한다면
Mono<PaymentResult> mono = Mono.just(result);
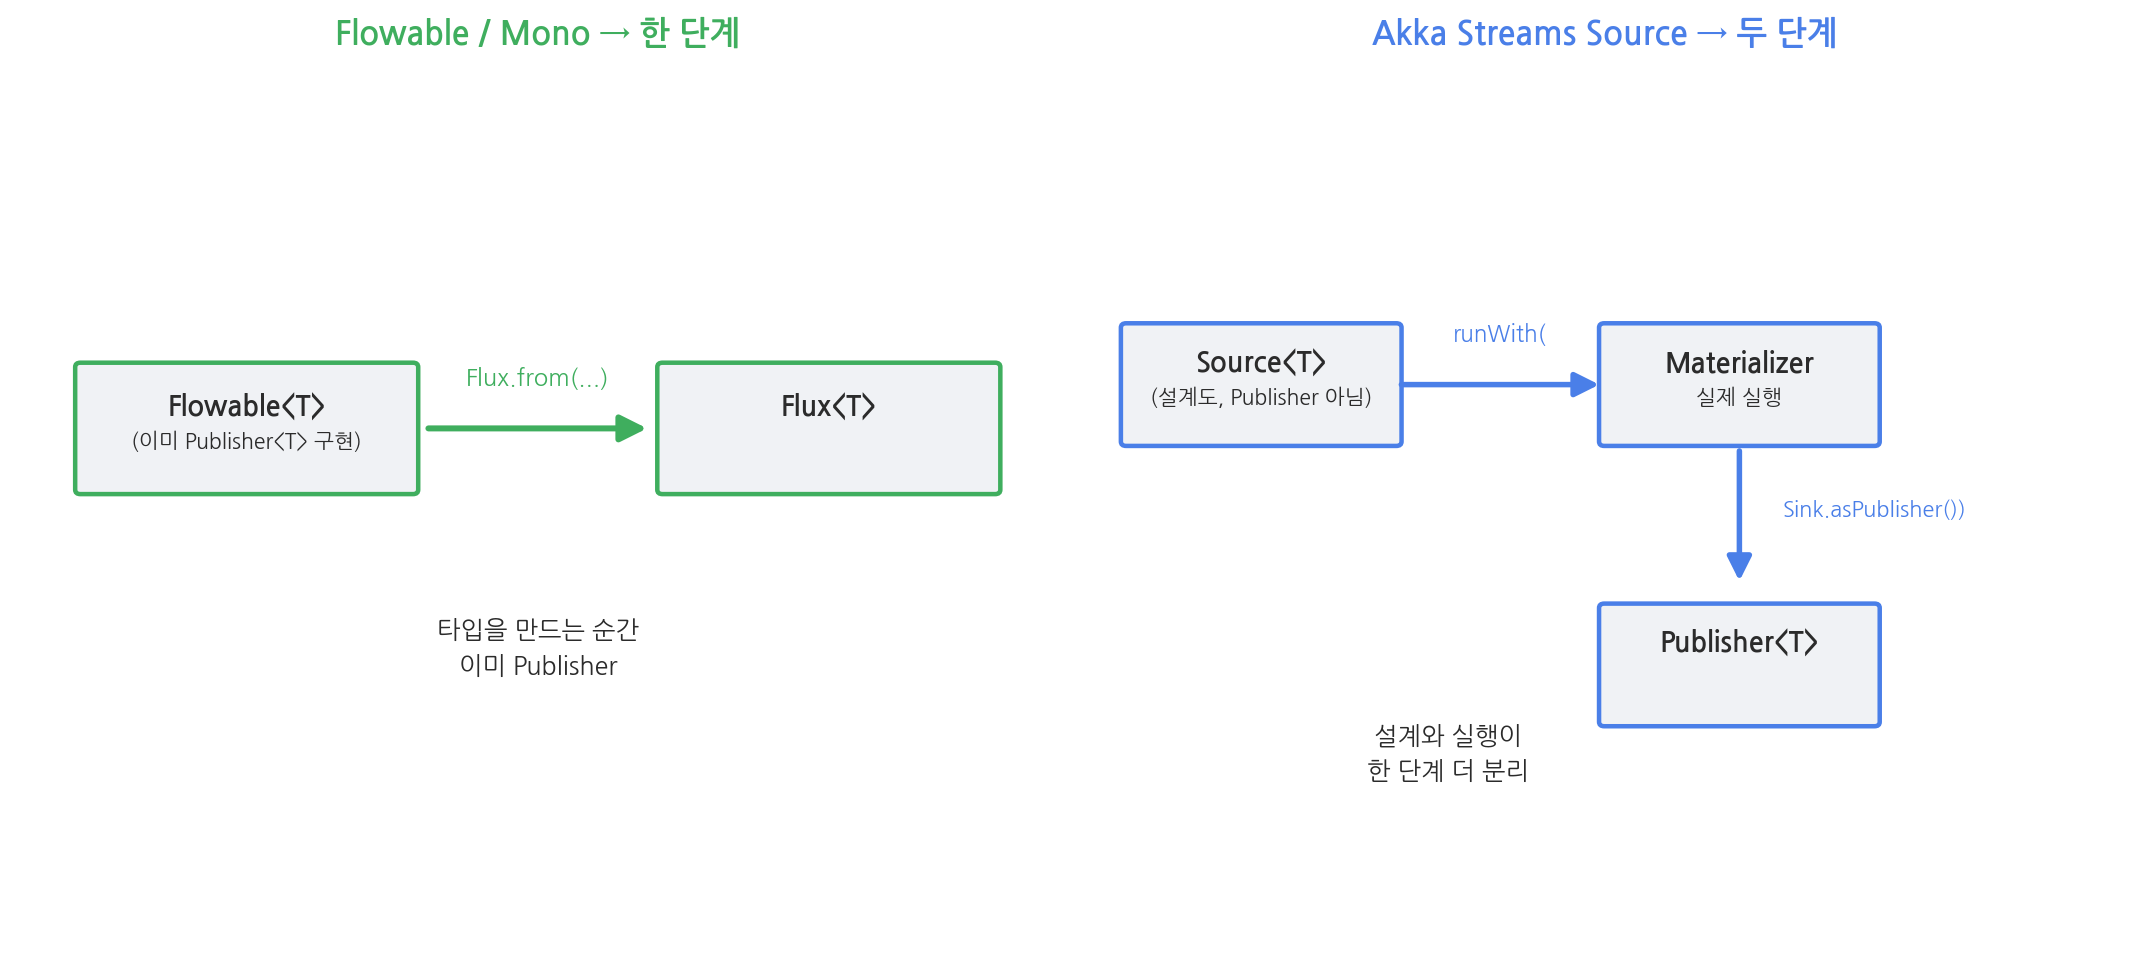
Flowable<PaymentResult> toRx = Flowable.fromPublisher(mono);Flowable과 Mono 모두 Publisher<T>를 구현하고 있어서, 서로의 팩토리 메서드에 그대로 넘기기만 하면 변환이 끝납니다.
다만 Akka Streams의 Source는 다릅니다. Source 자체는 아직 실행되지 않은 설계도일 뿐 Publisher가 아니라서, Materializer로 source.runWith(Sink.asPublisher(...))처럼 실행해야 비로소 Publisher가 나옵니다. Reactor나 RxJava는 타입을 만드는 순간 바로 Publisher지만, Akka Streams는 "설계"와 "실행"이 한 단계 더 분리되어 있는 구조입니다.
다음 편에서는 Reactor 내부로 한 걸음 더 들어가 봅니다. map, flatMap 같은 연산자들이 실제로는 어떤 Subscriber/Publisher 체인을 만들어내는지, 그리고 스케줄러(Scheduler)가 스레드를 어떻게 나눠 쓰는지를 코드 레벨에서 뜯어보겠습니다.
'Spring Framework > Spring WebFlux' 카테고리의 다른 글
| [Spring WebFlux] 5편: Reactor의 배압 제어 - request(n)에서 전략까지 (0) | 2026.09.18 |
|---|---|
| [Spring WebFlux] 4편: Cold/Warm/Hot Sequence (1) | 2026.09.15 |
| [Spring WebFlux] 2편: Reactive Streams 스펙 - 계약과 용어 (1) | 2026.09.14 |
| [Spring WebFlux] 1편: 리액티브 프로그래밍이란 무엇인가 (0) | 2026.09.14 |


