지난 편에서는 여전히 문으로 남아있는 for/while 루프의 순회 방식과, 식으로도 쓰이는 throw, 그리고 자바와 다른 코틀린의 예외 처리 방식(멀티캐치 없음, checked exception 없음)까지 살펴봤습니다.
https://dmoritle.tistory.com/289
[Kotlin] 코틀린 온보딩 5편 - 루프와 예외 처리: for/while과 try-catch
지난 편에서는 enum class와 when을 엮어서 완전성 검사를 다시 짚어보고, when이 자바의 switch보다 훨씬 유연하게 쓰이는 지점들을 살펴봤습니다.https://dmoritle.tistory.com/288?category=1362768 [Kotlin] 코틀린
dmoritle.tistory.com
이번 편에서는 함수를 호출할 때 쓸 수 있는 네 가지 문법 - 이름 있는 인자, 디폴트 파라미터, vararg, infix - 를 바이트코드 레벨까지 살펴보고, 마지막으로 클래스 밖에 함수와 프로퍼티를 선언하는 최상위 함수·프로퍼티까지 다뤄보겠습니다.
- 이름 있는 인자와 위치 인자 혼용 규칙
- 디폴트 파라미터 값과
@JvmOverloads - 가변 길이 인자(
vararg)와 스프레드 연산자 - 중위 함수(
infix) - 최상위 함수와 최상위 프로퍼티,
const val
이름 있는 인자 (Named Arguments)
코틀린은 함수를 호출할 때 파라미터 이름을 명시할 수 있습니다.
fun createUser(name: String, age: Int, isAdmin: Boolean) { ... }

createUser(name = "모리", age = 30, isAdmin = false)
createUser(age = 30, name = "모리", isAdmin = false)  // 순서 바꿔도 OK
위치 인자와 섞어 쓸 때의 규칙
위치 인자(positional argument)와 이름 있는 인자를 섞을 수도 있는데, 여기엔 규칙이 하나 있습니다. 한 번 이름 있는 인자를 쓰기 시작하면, 그 뒤에 오는 인자는 전부 이름을 명시해야 합니다.
fun foo(a: Int, b: Int, c: Int) { ... }

foo(1, c = 3, b = 2)   // OK: a는 위치로, 그 뒤는 전부 이름으로
foo(a = 1, 2, 3)       // 컴파일 에러: 이름 있는 인자 뒤에 위치 인자가 옴
즉 순서를 자유롭게 바꿀 수 있는 건 정확히는 이름 있는 인자들끼리의 이야기이고, 위치 인자는 여전히 선언 순서를 지켜야 합니다.
자바에서는 이름 있는 인자를 쓸 수 없다: 이름 있는 인자는 자바 언어 자체가 지원하지 않는 호출 문법이라, 코틀린↔자바 양방향 모두에서 쓸 수 없습니다. 코틀린 함수의 파라미터 이름이 바이트코드 디버그 정보(
LocalVariableTable)에 남아있어도 자바 컴파일러는 애초에name = value형태를 파싱하지 못하고, 반대로 자바 클래스 파일에는 파라미터 이름이 신뢰할 수 있는 형태로 보존되지 않기 때문에(컴파일 옵션에 따라 달라짐) 코틀린 컴파일러도 자바 메서드에 대해서는 이 문법 자체를 허용하지 않습니다.
디폴트 파라미터 값
파라미터에 기본값을 지정해두면 호출할 때 생략할 수 있습니다.
fun createUser(name: String, isAdmin: Boolean = false, id: String = generateId()) {
    println("$name, admin=$isAdmin, id=$id")
}

createUser("모리")                        // isAdmin, id는 기본값 사용
createUser("모리", isAdmin = true)          // id만 기본값 사용
디폴트 값은 상수일 필요가 없고, 함수 호출이나 앞선 파라미터를 참조하는 임의의 표현식이어도 됩니다.
fun repeat(text: String, times: Int = text.length): String = text.repeat(times)이름 있는 인자와의 시너지: 중간 파라미터만 지정
디폴트 파라미터의 진짜 위력은 이름 있는 인자와 결합했을 때 나옵니다. 자바였다면 오버로딩을 여러 개 만들어야 했을 상황을, 코틀린에서는 함수 하나로 처리할 수 있습니다.
fun createUser(
    name: String,
    isAdmin: Boolean = false,
    id: String = generateId(),
    createdAt: Long = System.currentTimeMillis()
) { ... }

// createdAt만 직접 지정하고 나머지는 기본값 사용
createUser(name = "모리", createdAt = 0L)
isAdmin과 id를 건너뛰고 createdAt만 지정하는 게 위치 인자만으로는 불가능한데, 이름 있는 인자 덕분에 자연스럽게 됩니다.
자바 상호운용성에서 주의할 점
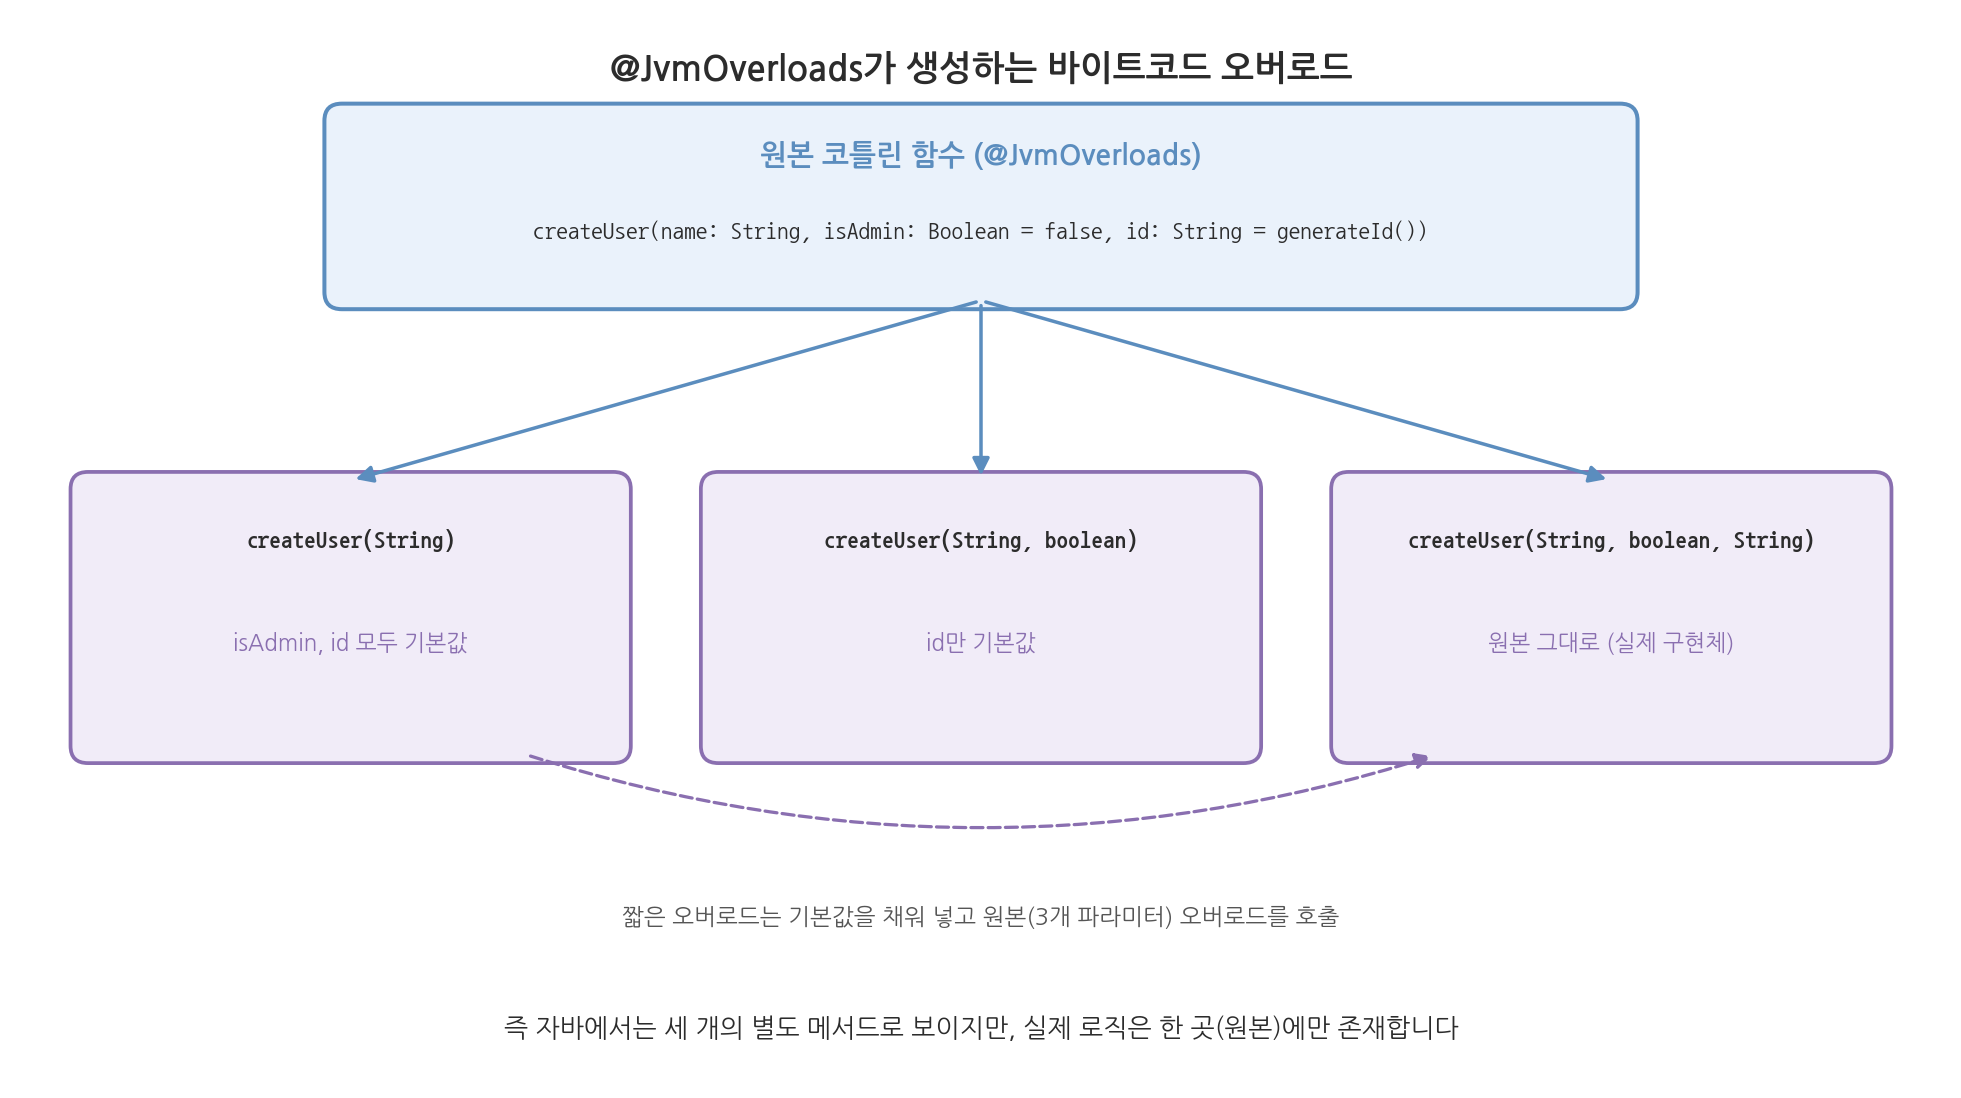
자바 코드에서는 디폴트 파라미터라는 개념이 없기 때문에, 자바 쪽에서 코틀린 함수를 호출할 땐 디폴트 값이 있어도 모든 인자를 다 넘겨야 합니다. 이걸 해결하려면 @JvmOverloads 애노테이션을 붙여서, 디폴트 파라미터를 하나씩 제외한 오버로드 메서드들을 컴파일러가 자동 생성하게 만들어야 합니다.
@JvmOverloads
fun createUser(name: String, isAdmin: Boolean = false, id: String = generateId()) { ... }
이러면 바이트코드 상에 createUser(String), createUser(String, boolean), createUser(String, boolean, String) 세 개의 오버로드가 생성됩니다.
가변 길이 인자 (vararg)
파라미터 개수를 정해두지 않고, 호출할 때 원하는 만큼 인자를 넘길 수 있게 해주는 문법입니다.
fun printAll(vararg names: String) {
    for (name in names) println(name)
}

printAll("모리")
printAll("모리", "예진")
printAll()   // 인자 없이 호출도 가능
함수 본문 안에서 names는 Array<String>(원시 타입이면 IntArray 등)으로 취급됩니다. 자바의 가변 인자(String... names)와 개념은 같지만, 코틀린은 원시 타입 배열(IntArray 등)까지 박싱 없이 그대로 처리한다는 점이 다릅니다.
스프레드 연산자(*)로 배열 펼치기
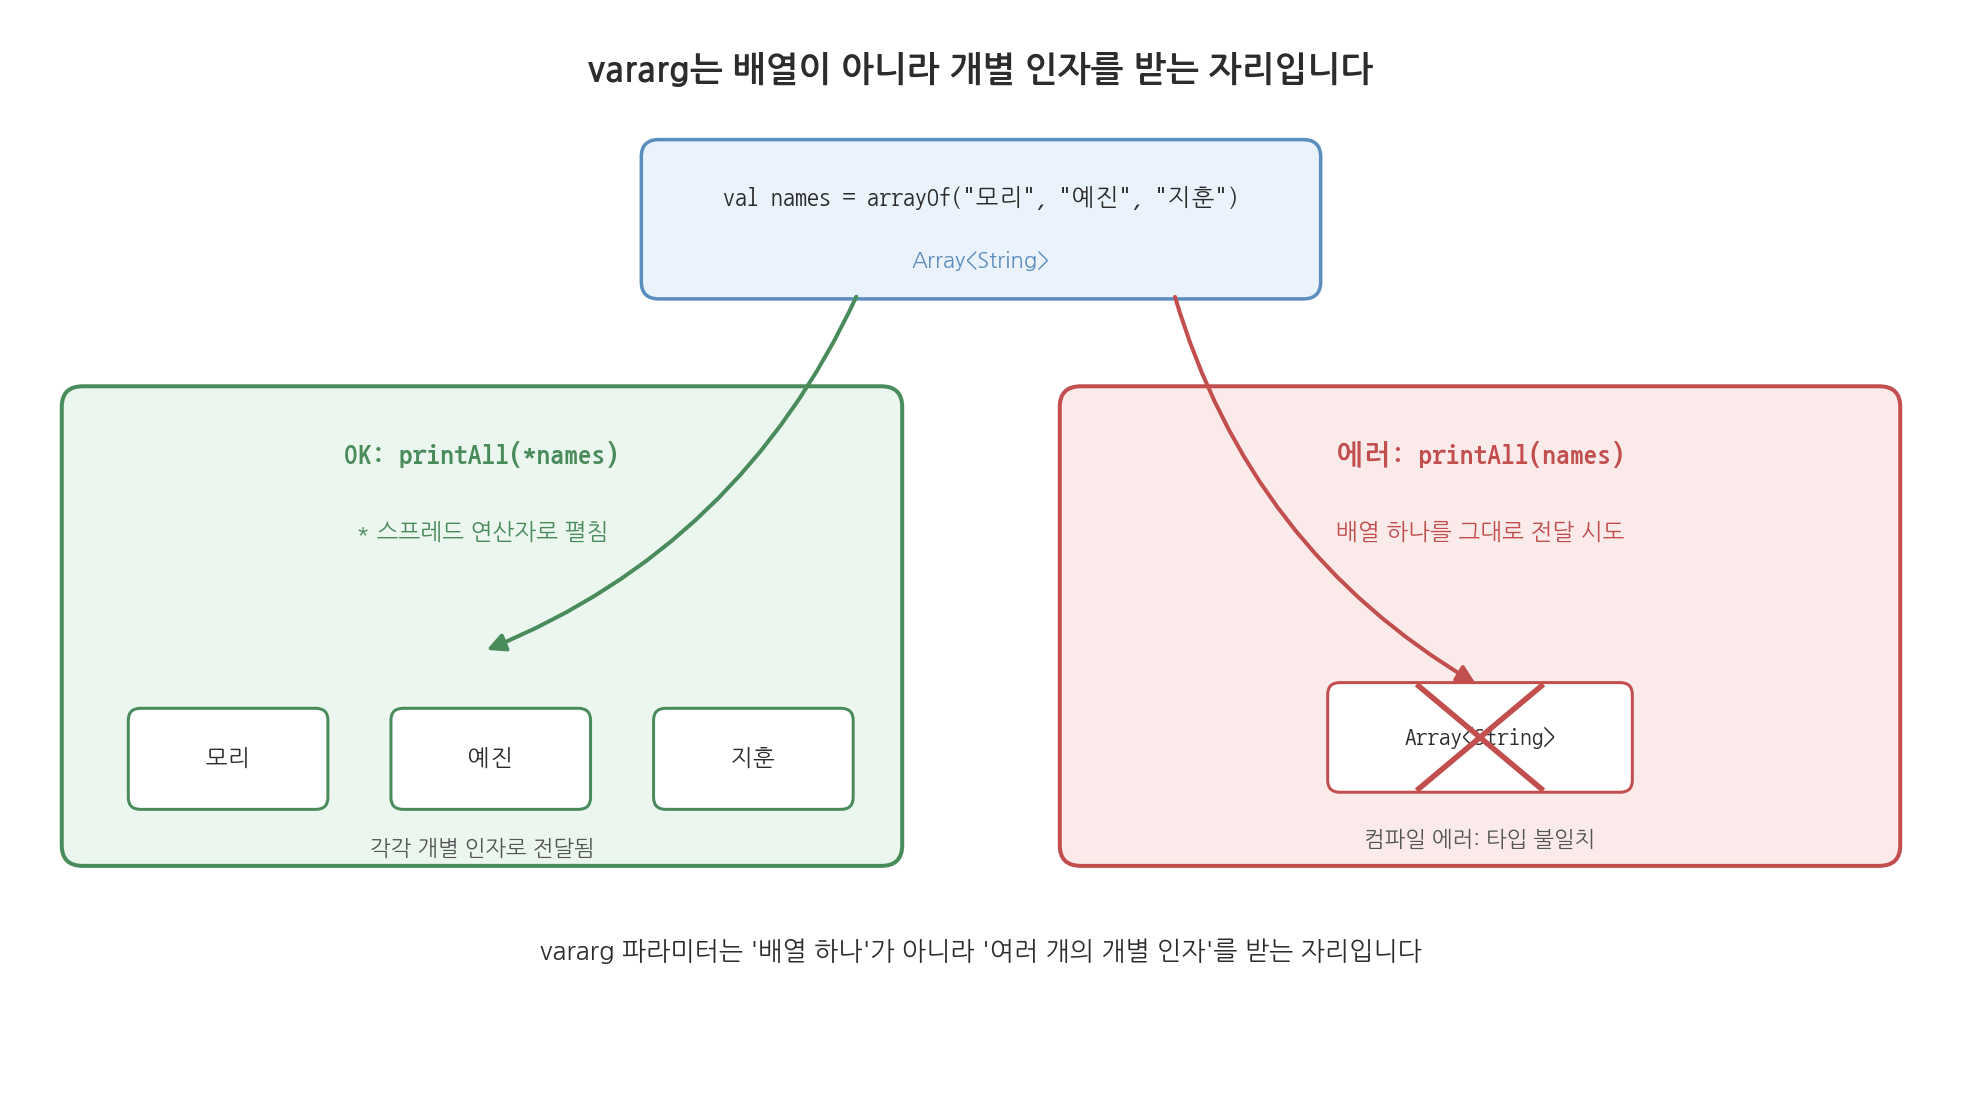
이미 배열(또는 컬렉션)로 갖고 있는 데이터를 vararg 함수에 그대로 넘기고 싶을 때는 *(스프레드 연산자)를 씁니다.
val names = arrayOf("모리", "예진", "지훈")
printAll(*names)          // 배열을 펼쳐서 각각의 인자로 전달

val list = listOf("모리", "예진")
printAll(*list.toTypedArray()) // List는 바로 안 되고, 배열로 변환 후 스프레드printAll(names)처럼 배열을 그냥 넘기면 컴파일 에러가 납니다. vararg 파라미터는 "배열 하나"가 아니라 "여러 개의 개별 인자"를 받는 자리이기 때문에, 배열을 그 자리에 그대로 대입할 수 없고 반드시 펼쳐서(spread) 넘겨야 합니다.
vararg와 다른 파라미터를 함께 쓸 때
vararg는 어느 위치에나 선언할 수 있지만, vararg 뒤에 오는 파라미터는 반드시 이름을 명시해서 호출해야 합니다.
fun printAll(vararg names: String, separator: String) {
    println(names.joinToString(separator))
}

printAll("모리", "예진", separator = ", ")   // separator는 이름 필수
이 규칙은 앞서 다룬 이름 있는 인자 개념과 자연스럽게 이어집니다. vararg가 몇 개의 인자를 먹을지 컴파일러 입장에서 호출부만 보고는 알 수 없기 때문에, 그 뒤 파라미터는 이름으로 명확히 구분해줘야 하는 것입니다.
한 함수에는 vararg 파라미터가 최대 하나만 있을 수 있습니다.
바이트코드 관점: 그냥 배열 파라미터
vararg는 자바의 가변 인자와 마찬가지로 바이트코드에서는 그냥 배열 파라미터입니다.
fun printAll(vararg names: String) { ... }public static void printAll(String[] names) { ... }즉 언어 차원에서 새로운 게 추가된 게 아니라, 배열 파라미터를 호출부에서 콤마로 나열해서 넘길 수 있게 해주는 호출 문법 설탕이고, 스프레드 연산자는 그 배열을 그대로 넘기라는 표시일 뿐입니다.
중위 함수 (Infix Functions)
infix 키워드가 붙은 함수는 점(.)과 괄호를 생략하고 수신객체 함수이름 인자 형태로 호출할 수 있습니다.
infix fun Int.add(other: Int): Int = this + other

val a = 3.add(4)   // 일반 호출
val b = 3 add 4 // infix 호출잠깐:
Int.add처럼 타입 이름 뒤에 점을 찍고 함수를 선언하는 문법은 확장 함수라고 부릅니다. 기존 클래스를 건드리지 않고도 새 함수를 그 타입에 추가하는 문법인데, 자세한 내용은 다음 편에서 다루겠습니다. 지금은 "Int타입에add라는 함수를 새로 붙였다" 정도로 이해하고 넘어가면 충분합니다.
가장 익숙한 예시는 to입니다.
infix fun <A, B> A.to(that: B): Pair<A, B> = Pair(this, that)

val pair = "모리" to 30 // "모리".to(30) 과 동일to도 앞서 본 add처럼 확장 함수 위에 infix를 붙인 형태입니다. 확장 함수 자체는 다음 편에서 자세히 다루겠지만, infix는 확장 함수든 멤버 함수든 상관없이 붙일 수 있고, 그 함수를 어떤 모양으로 호출할 수 있는지에만 관여한다는 점을 기억해두면 됩니다.
조건: 파라미터가 정확히 하나
infix 함수는 파라미터를 정확히 하나만 가질 수 있고, 그 파라미터는 디폴트 값을 가질 수 없으며 vararg도 될 수 없습니다.
infix fun Int.between(range: IntRange): Boolean = this in range   // OK: 파라미터 1개

// infix fun Int.foo(a: Int, b: Int): Int = a + b   // 컴파일 에러: 파라미터 2개
// infix fun Int.bar(x: Int = 0): Int = x            // 컴파일 에러: 디폴트 값 불가
멤버 함수로 선언할 때도 확장 수신 객체가 아니라 디스패치 수신 객체(클래스 자기 자신)를 기준으로 "파라미터 하나"라는 조건이 똑같이 적용됩니다.
class Money(val amount: Int) {
    infix fun plus(other: Money): Money = Money(amount + other.amount)
}

val total = Money(1000) plus Money(500)
표준 라이브러리의 infix 함수들
코틀린 표준 라이브러리 곳곳에 infix 함수가 이미 쓰이고 있습니다.
val pair = "key" to "value"       // Pair 생성
val range = 1 until 10             // 1..9 (끝 미포함 범위)
val flags = 0b1010 and 0b0110 // 비트 ANDand, or, shl, shr 등은 Int의 멤버 함수로 infix가 붙어 있어서, 자바에서 &, |, << 같은 연산자로 쓰던 비트 연산을 코틀린에서는 이름 있는 함수 호출로 표현합니다.
바이트코드 관점: 컴파일 타임에만 존재
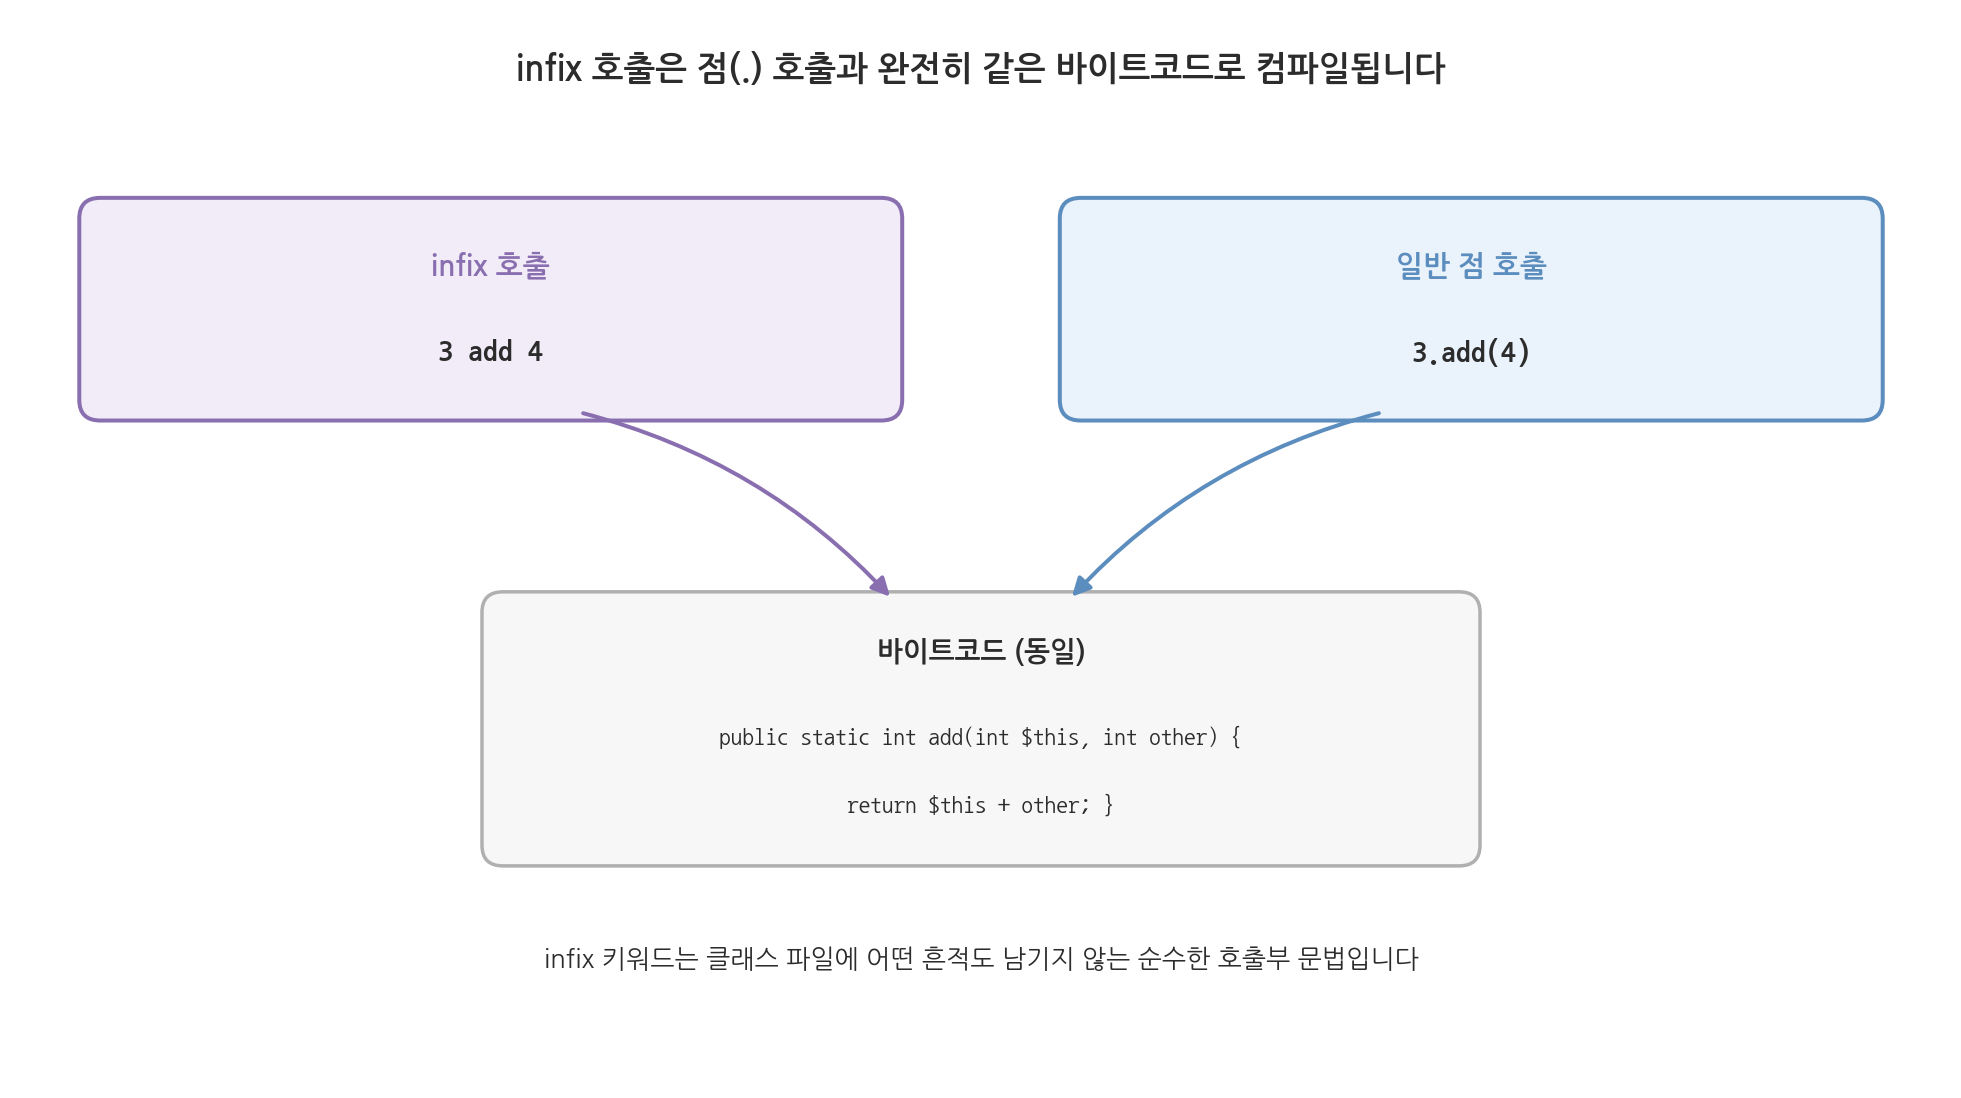
infix 역시 호출부 문법에만 영향을 주는 컴파일 타임 개념입니다. 3 add 4와 3.add(4)는 완전히 동일한 바이트코드로 컴파일됩니다.
public static int add(int $this, int other) {
    return $this + other;
}
즉 infix 키워드는 클래스 파일 어디에도 흔적을 남기지 않고, 오직 코틀린 컴파일러가 소스를 파싱할 때 수신객체 함수이름 인자 형태의 호출을 허용해줄지 판단하는 데만 쓰입니다.
최상위 함수와 최상위 프로퍼티
지금까지는 함수를 어떻게 "호출"하는지를 봤는데, 이 절에서는 잠깐 방향을 바꿔서 함수와 프로퍼티를 어디에 "선언"할 수 있는지를 살짝 넓혀보겠습니다. 코틀린은 클래스 밖, 파일에 바로 함수나 프로퍼티를 선언할 수 있습니다.
최상위 함수 (Top-level Function)
// file: MathUtils.kt
package com.example

fun square(x: Int): Int = x * x
바이트코드로 컴파일되면 파일명 기반 클래스의 정적 메서드가 됩니다.
public final class MathUtilsKt {
    public static int square(int x) {
        return x * x;
    }
}
다음 편에서 다룰 확장 함수도 사실은 최상위 함수의 한 특수한 형태일 뿐입니다. 수신 객체를 첫 번째 파라미터로 받는다는 특징만 추가되고, 파일명 기반 클래스의 정적 메서드로 컴파일되는 방식은 동일합니다.
파일명과 다른 클래스 이름을 쓰고 싶다면 @file:JvmName으로 지정할 수 있습니다.
@file:JvmName("MathUtils")

fun square(x: Int): Int = x * x
최상위 프로퍼티 (Top-level Property)
함수와 마찬가지로 프로퍼티도 클래스 밖에 선언할 수 있습니다.
// file: Config.kt
package com.example

val PI_APPROX = 3.14
var counter = 0
다음 편에서 다룰 확장 프로퍼티는 backing field가 없어서 매번 getter가 계산해서 반환하는 방식인데, 최상위 프로퍼티는 이와 달리 진짜 상태를 저장하는 프로퍼티입니다. 바이트코드로는 대략 이렇게 컴파일됩니다.
public final class ConfigKt {
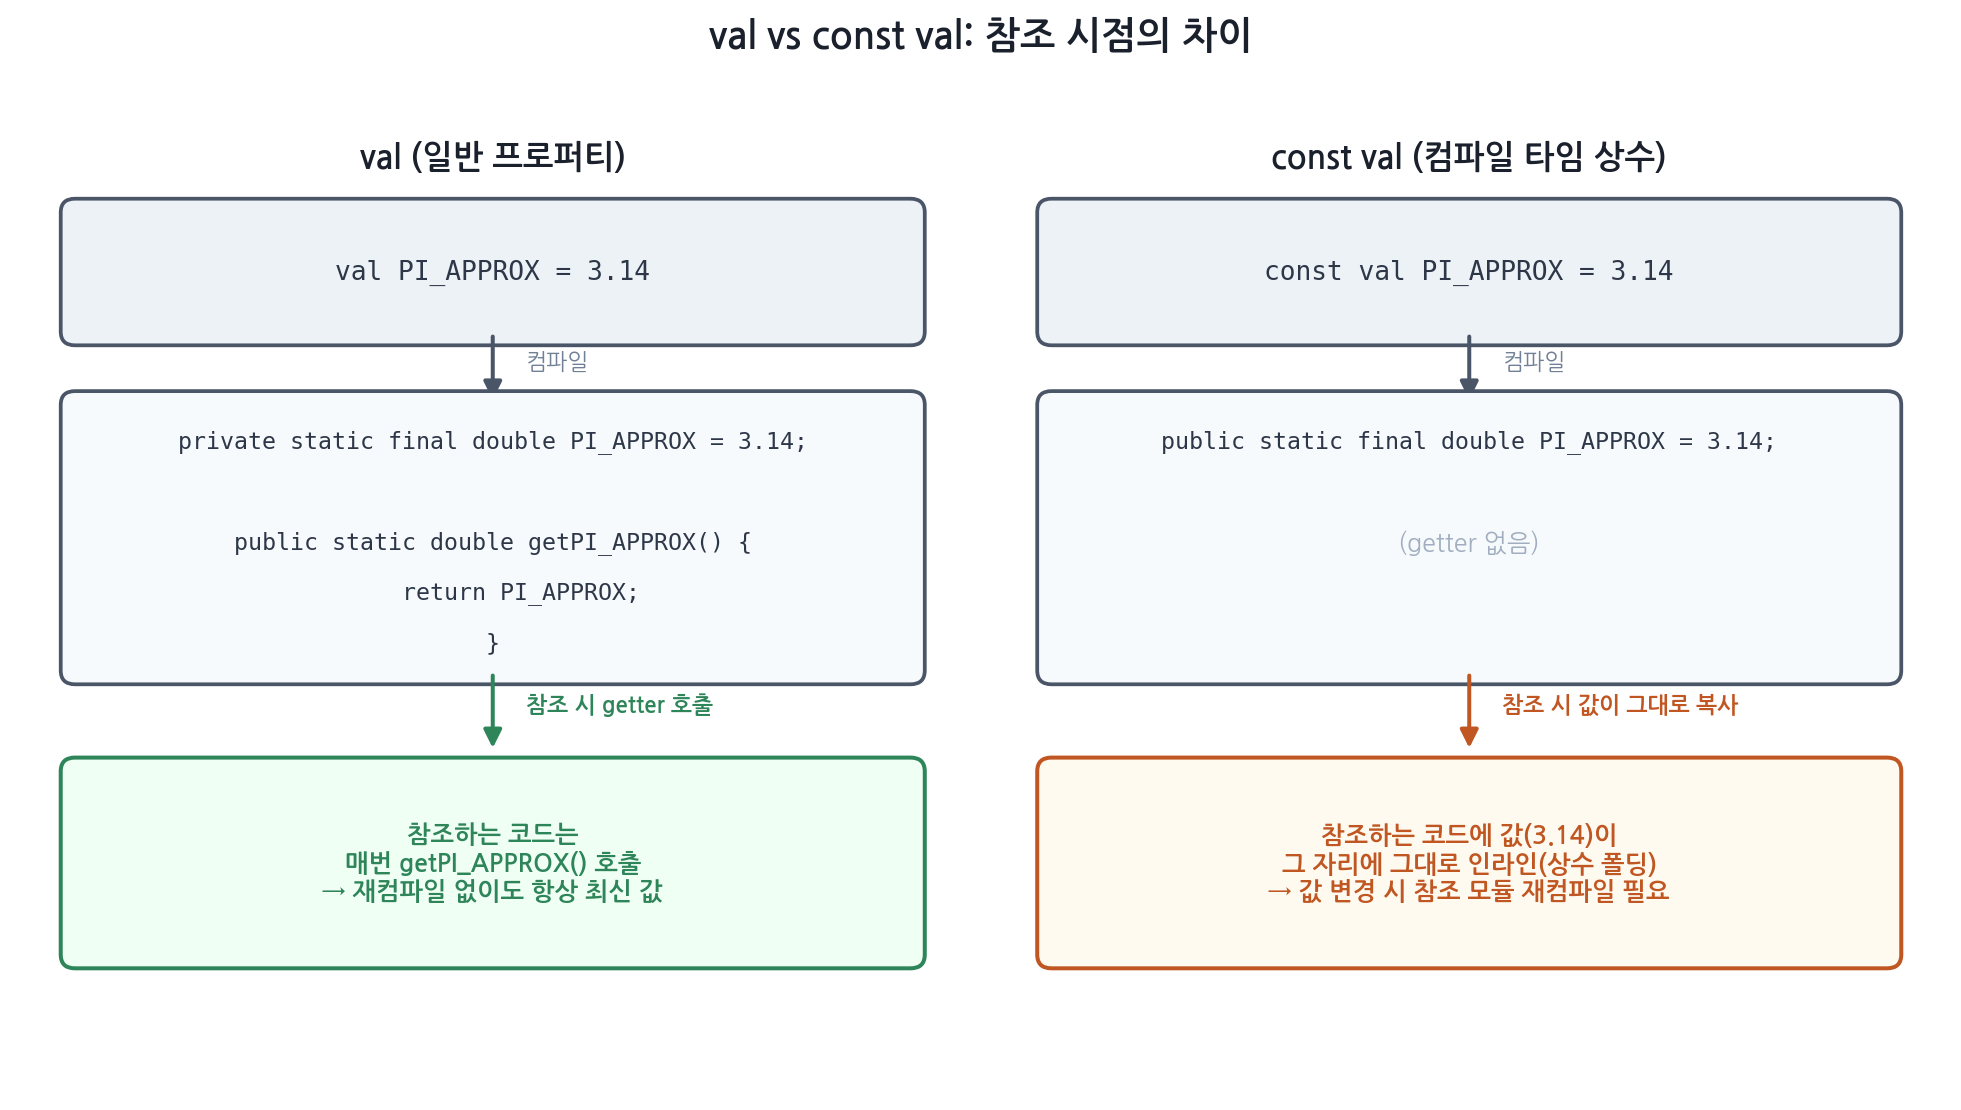
    private static final double PI_APPROX = 3.14;
    private static int counter = 0;

    public static double getPI_APPROX() { return PI_APPROX; }
    public static int getCounter() { return counter; }
    public static void setCounter(int value) { counter = value; }
}
즉 private static 필드 + public static getter/setter 쌍으로 컴파일됩니다. 자바 코드에서 코틀린 최상위 프로퍼티에 접근할 때 ConfigKt.getCounter()처럼 메서드 호출로 보이는 이유가 여기 있습니다.
const val: 진짜 컴파일 타임 상수
만약 원시 타입이나 String이고 컴파일 타임에 값이 확정되는 경우라면, const 키워드를 붙여 진짜 컴파일 타임 상수로 만들 수 있습니다.
const val PI_APPROX = 3.14
이 경우엔 getter가 아예 생성되지 않고, public static final 필드로 직접 노출됩니다.
public final class ConfigKt {
    public static final double PI_APPROX = 3.14;
}
더 중요한 차이는, const val을 참조하는 코드는 컴파일 시점에 값이 그 자리에 그대로 인라인(상수 폴딩)된다는 점입니다. 클래스 파일의 ConstantValue 속성으로 박히는 자바의 static final 상수와 동일한 동작입니다. 이 때문에 const val의 값을 나중에 바꾸고 그 값을 참조하던 다른 모듈을 재컴파일하지 않으면, 그 모듈은 여전히 옛날 값을 참조하는 바이너리 호환성 문제가 생길 수 있습니다. 반면 일반 val(getter 방식)은 참조하는 쪽이 항상 최신 getter를 호출하므로 이 문제가 없습니다.
| 구분 | val | const val |
| 컴파일 결과 | private static final 필드 + public static getter |
public static final 필드 (getter 없음) |
| 참조 시점 | 매번 getter 호출 | 컴파일 타임에 값이 그대로 인라인됨 |
| 사용 가능 타입 | 모든 타입 | 원시 타입과 String만, 컴파일 타임 상수 표현식만 |
| 값 변경 시 | 재컴파일 없이도 항상 최신 값 반영 | 참조하는 모듈을 재컴파일해야 최신 값 반영 |
정리
| 핵심 개념 | 요약 |
| 이름 있는 인자 | 파라미터 이름을 명시해 순서 없이 호출 가능. 단, 이름 있는 인자 뒤에는 위치 인자를 쓸 수 없음 |
| 자바 호환성 | 자바는 이름 있는 인자 호출 문법 자체를 지원하지 않음 — 양방향(코틀린↔자바) 모두 사용 불가 |
| 디폴트 파라미터 | 파라미터에 기본값을 지정해 호출 시 생략 가능. 이름 있는 인자와 결합하면 중간 파라미터만 지정 가능 |
@JvmOverloads |
자바 호환을 위해 디폴트 파라미터를 하나씩 제외한 오버로드를 자동 생성 |
| vararg | 개수 제한 없이 인자를 받는 파라미터. 바이트코드에서는 그냥 배열 파라미터 |
스프레드 연산자(*) |
배열/컬렉션을 vararg 자리에 개별 인자처럼 펼쳐서 전달 |
| vararg 뒤 파라미터 | 반드시 이름 있는 인자로 호출해야 함 |
| infix | 파라미터가 정확히 하나인 함수에 붙여 점과 괄호 없이 호출 가능하게 하는 호출 문법 |
| 최상위 함수 | 파일명 기반 클래스의 정적 메서드로 컴파일. 확장 함수와 같은 메커니즘, 수신 객체 유무만 차이 |
| 최상위 프로퍼티 | private static 필드 + public static getter/setter로 컴파일. 확장 프로퍼티와 달리 실제 상태를 저장 |
const val |
getter 없이 public static final 필드로 노출되고 참조 지점에 값이 인라인됨(상수 폴딩) |
마무리
이름 있는 인자와 디폴트 파라미터, vararg와 스프레드 연산자, infix, 그리고 클래스 밖에 선언하는 최상위 함수·프로퍼티(const val 포함)까지 함수를 호출하고 선언하는 다양한 문법을 바이트코드 레벨에서 살펴봤습니다. 다음 편에서는 이번 편에서 잠깐 맛본 Int.add처럼, 그리고 최상위 함수의 한 특수한 형태이기도 한 기존 클래스를 건드리지 않고도 새 함수·프로퍼티를 추가하는 확장 함수와 확장 프로퍼티를 다뤄보겠습니다.
이 시리즈는 『코틀린 인 액션(Kotlin in Action)』을 참고하여 작성했습니다.
이번 편에서 다룬 내용은 아래 문서로도 검증했습니다.
'Language > Kotlin' 카테고리의 다른 글
| [Kotlin] 코틀린 온보딩 7편 - 확장 함수: 바이트코드로 확장 프로퍼티까지 이해하기 (0) | 2026.09.26 |
|---|---|
| [Kotlin] 코틀린 온보딩 5편 - 루프와 예외 처리: for/while과 try-catch (0) | 2026.09.26 |
| [Kotlin] 코틀린 온보딩 4편 - enum과 when: 완전성 검사 다시 보기 (0) | 2026.09.26 |
| [Kotlin] 코틀린 온보딩 3편 - 클래스와 프로퍼티: 커스텀 접근자로 이해하기 (0) | 2026.09.26 |
| [Kotlin] 코틀린 온보딩 2편 - 변수: val/var와 문자열 템플릿으로 이해하기 (1) | 2026.09.06 |


